# GIT
## Genel Bakış
GIT modeli, Jianfeng Wang, Zhengyuan Yang, Xiaowei Hu, Linjie Li, Kevin Lin, Zhe Gan, Zicheng Liu, Ce Liu ve Lijuan Wang tarafından [GIT: A Generative Image-to-text Transformer for Vision and Language](https://huggingface.co/papers/2205.14100) makalesinde önerilmiştir. GIT, yalnızca çözücü (decoder-only) bir Transformer'dır ve [CLIP](clip)'in görme kodlayıcısını (vision encoder) kullanarak modeli, metnin yanı sıra görme girdilerine de koşullandırır. Model, görüntü altyazılama (image captioning) ve görsel soru yanıtlama (visual question answering) kıyaslamalarında (benchmarks) en iyi sonuçları elde etmektedir.
Makalenin özeti aşağıdaki gibidir:
*Bu makalede, görüntü/video altyazılama ve soru-cevap gibi görme-dil görevlerini birleştirmek üzere Generative Image-to-text Transformer (GIT) adlı bir modeli tasarlayıp eğittik. Üretken modeller, ön eğitim ve ince ayar arasında tutarlı bir ağ mimarisi sağlasa da mevcut çalışmalar genellikle karmaşık yapılara (tekli/çok modlu kodlayıcı/çözücü) sahiptir ve nesne dedektörleri/etiketleyiciler ile optik karakter tanıma (OCR) gibi dış modüllere bağımlıdır. GIT'te, mimariyi tek bir dil modelleme görevi altında tek bir görüntü kodlayıcı ve tek bir metin çözücü olarak sadeleştirdik. Ayrıca model performansını artırmak için ön eğitim verisini ve model boyutunu ölçeklendirdik. Ekstra süsler olmadan, GIT'ımız 12 zorlu ölçekte büyük bir farkla yeni en iyi sonuçları (state of the art) elde etmektedir. Örneğin, modelimiz TextCaps'ta (CIDEr'da 138.2 vs. 125.5) ilk kez insan performansını geride bırakmıştır. Bunun yanı sıra, üretim tabanlı görüntü sınıflandırma ve sahne metni tanıma için yeni bir şema sunarak standart ölçekte iyi performanslar elde ettik.*
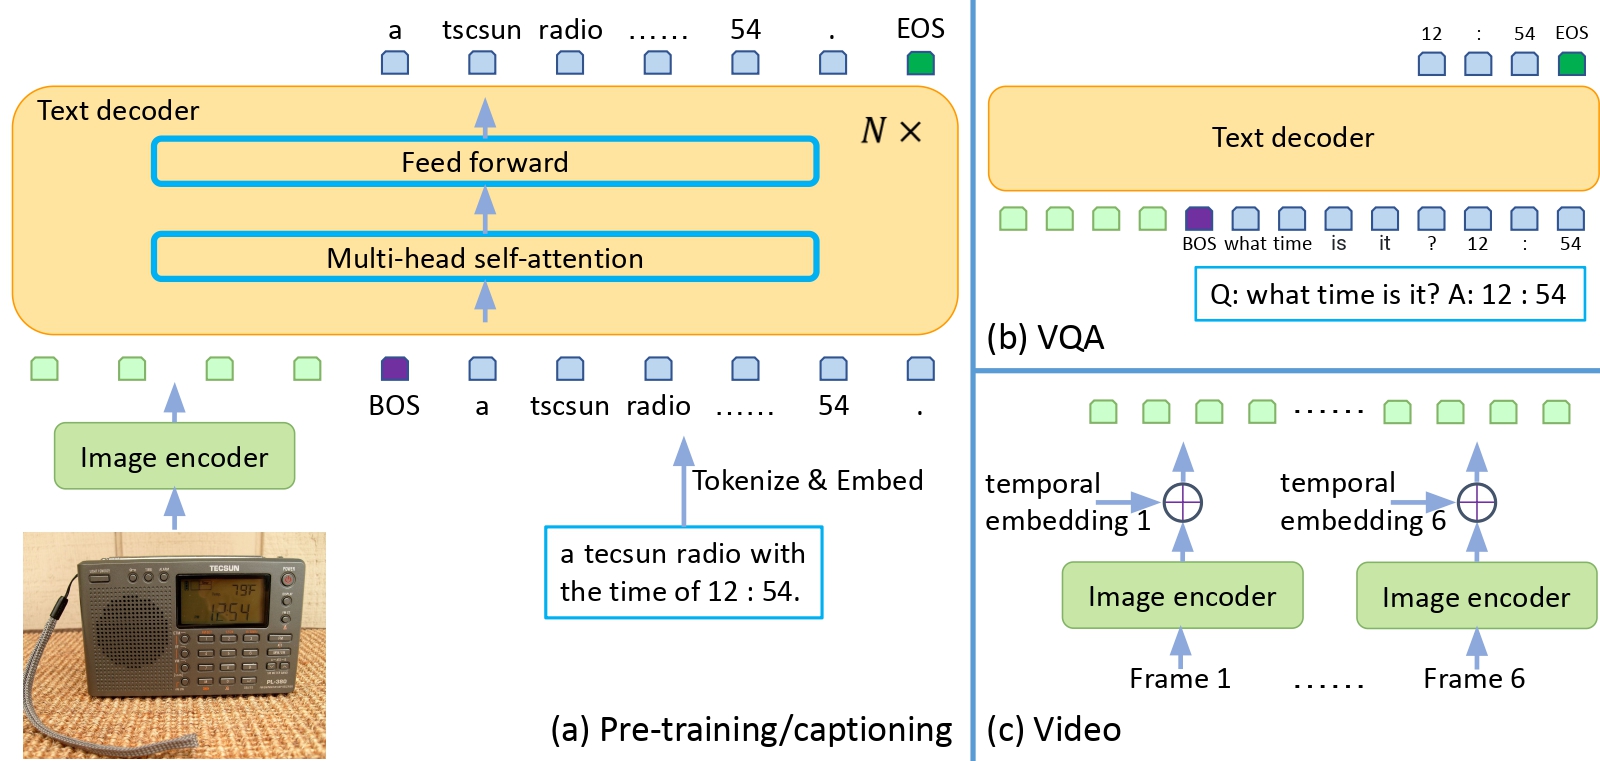 GIT mimarisi. Orijinal makaleden alınmıştır.
Bu model [nielsr](https://huggingface.co/nielsr) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/microsoft/GenerativeImage2Text) bulunabilir.
## Kullanım ipuçları
- GIT, GPT-2 ile çok benzer bir şekilde uygulanmıştır; tek fark, modelin `pixel_values` üzerinde de koşullandırılmış olmasıdır.
## Kaynaklar
GIT ile başlamanıza yardımcı olmak için resmi Hugging Face ve topluluk (🌎 ile belirtilen) kaynaklarının listesi.
- Özel verilerde GIT için çıkarım + ince ayar hakkında demo defterleri [burada](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/GIT) bulunabilir.
- Bkz: [Nedensel dil modelleme görevi kılavuzu](../tasks/language_modeling)
Buraya bir kaynak eklemek isterseniz, bir Pull Request açmaktan çekinmeyin; inceleyeceğiz. Kaynağın, mevcut bir kaynağı tekrarlamak yerine ideal olarak yeni bir şeyi göstermesi beklenir.
## GitVisionConfig[[transformers.GitVisionConfig]]
#### transformers.GitVisionConfig[[transformers.GitVisionConfig]]
```python
transformers.GitVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/git/configuration_git.py#L27)
**Parametreler:**
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
intermediate_size (`int`, *isteğe bağlı*, varsayılan `3072`) : MLP temsil boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
num_channels (`int`, *opsiyonel*, varsayılan `3`) : Girdi kanal sayısı.
image_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `224`) : Her bir görüntünün boyutu (çözünürlüğü).
patch_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `16`) : Her yamanın boyutu (çözünürlüğü).
hidden_act (`str`, *isteğe bağlı*, varsayılan `quick_gelu`) : Dekoderdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-05`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
attention_dropout (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Dikkat olasılıkları için dropout oranı.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
Bu, bir GitModel'in yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Git modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılanlarla bir yapılandırma örneği oluşturmak, [microsoft/git-base](https://huggingface.co/microsoft/git-base) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import GitVisionConfig, GitVisionModel
>>> # Initializing a GitVisionConfig with microsoft/git-base style configuration
>>> configuration = GitVisionConfig()
>>> # Initializing a GitVisionModel (with random weights) from the microsoft/git-base style configuration
>>> model = GitVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GitVisionModel[[transformers.GitVisionModel]]
#### transformers.GitVisionModel[[transformers.GitVisionModel]]
```python
transformers.GitVisionModel(config: GitVisionConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/git/modeling_git.py#L634)
**Parametreler:**
config ([GitVisionConfig](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitVisionConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
GIT'te kullanılan, üzerinde herhangi bir başlık veya projeksiyon bulunmayan CLIP'in görme modeli.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.GitVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/git/modeling_git.py#L652)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [CLIPImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/clip#transformers.CLIPImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [CLIPImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([GitProcessor](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitProcessor), görüntü işleme için [CLIPImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/clip#transformers.CLIPImageProcessor) kullanır).
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** [BaseModelOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutput) veya `tuple(torch.Tensor)`
Yapılandırmaya ([GitConfig](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşan bir [BaseModelOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutput) veya `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda).
[GitVisionModel](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitVisionModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, GitVisionModel
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base")
>>> model = GitVisionModel.from_pretrained("microsoft/git-base")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
```
## GitConfig[[transformers.GitConfig]]
#### transformers.GitConfig[[transformers.GitConfig]]
```python
transformers.GitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.models.git.configuration_git.GitVisionConfig | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 6, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 1024, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, use_cache: bool = True, tie_word_embeddings: bool = False, bos_token_id: int | None = 101, eos_token_id: int | list[int] | None = 102, num_image_with_embedding: int | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/git/configuration_git.py#L62)
**Parametreler:**
vision_config (`Union[dict, ~models.git.configuration_git.GitVisionConfig]`, *isteğe bağlı*) : Görüntü iskeletinin yapılandırma nesnesi veya sözlüğü.
vocab_size (`int`, *isteğe bağlı*, varsayılan `30522`) : Modelin sözlük boyutu. `input_ids` tarafından temsil edilebilecek farklı token sayısını tanımlar.
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `6`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
intermediate_size (`int`, *isteğe bağlı*, varsayılan `3072`) : MLP temsil boyutu.
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
hidden_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Gömme, kodlayıcı ve havuzlayıcıdaki tüm tam bağlı katmanlar için dropout olasılığı.
attention_probs_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Dikkat olasılıkları için dropout oranı.
max_position_embeddings (`int`, *isteğe bağlı*, varsayılan `1024`) : Bu modelin kullanılabileceği maksimum dizi uzunluğu.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-12`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
pad_token_id (`int`, *isteğe bağlı*, varsayılan `0`) : Sözlükte dolgu için kullanılan token kimliği.
use_cache (`bool`, *isteğe bağlı*, varsayılan `True`) : Modelin son anahtar/değer dikkatlerini döndürüp döndürmeyeceğini belirtir (tüm modellerde kullanılmaz). Yalnızca `config.is_decoder=True` olduğunda veya model yalnızca çözücü tabanlı üretken bir model olduğunda geçerlidir.
tie_word_embeddings (`bool`, *isteğe bağlı*, varsayılan `False`) : Ağırlık gömme bağlamalarının, modelin `tied_weights_keys` eşlemesine göre yapılıp yapılmayacağını belirtir.
bos_token_id (`int`, *isteğe bağlı*, varsayılan `101`) : Sözlükte akış başlangıcı için kullanılan token kimliği.
eos_token_id (`Union[int, list[int]]`, *isteğe bağlı*, varsayılan `102`) : Sözlükte akış sonu için kullanılan token kimliği.
num_image_with_embedding (`int`, *isteğe bağlı*) : Modelin video açıklama/VQA için kullanılması durumunda eklenecek zamansal gömme sayısı.
Bu, bir GitModel'in yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Git modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılanlarla bir yapılandırma örneği oluşturmak, [microsoft/git-base](https://huggingface.co/microsoft/git-base) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnekler:
```python
>>> from transformers import GitConfig, GitModel
>>> # Initializing a GIT microsoft/git-base style configuration
>>> configuration = GitConfig()
>>> # Initializing a model (with random weights) from the microsoft/git-base style configuration
>>> model = GitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GitProcessor[[transformers.GitProcessor]]
#### transformers.GitProcessor[[transformers.GitProcessor]]
```python
transformers.GitProcessor(image_processor, tokenizer)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/git/processing_git.py#L23)
**Parametreler:**
image_processor (`CLIPImageProcessor`) : Görüntü işleyici zorunlu bir girdidir.
tokenizer (`BertTokenizer`) : Tokenizer zorunlu bir girdidir.
Bir görüntü işleyiciyi ve bir belirteçleyiciyi tek bir işleyicide birleştiren bir GitProcessor oluşturur.
[GitProcessor](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitProcessor), [CLIPImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/clip#transformers.CLIPImageProcessor) ve [BertTokenizer](/docs/transformers/v5.23.0/tr/model_doc/lxmert#transformers.BertTokenizer) işlevselliğinin tamamını sunar. Daha fazla bilgi için [~CLIPImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/clip#transformers.CLIPImageProcessor) ve [~BertTokenizer](/docs/transformers/v5.23.0/tr/model_doc/lxmert#transformers.BertTokenizer) belgelerine bakın.
#### __call__[[transformers.GitProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *isteğe bağlı*) : Ön işleme tabi tutulacak görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
text (`Union[str, list[str], list[list[str]]]`, *isteğe bağlı*) : Kodlanacak dizi veya dizi topluluğu. Her dizi bir metin veya metin listesi (önceden tokenize edilmiş metin) olabilir. Önceden tokenize edilmiş bir girdi geçirirseniz, toplu girdilerle karışıklığı önlemek için `is_split_into_words=True` değerini ayarlayın.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *isteğe bağlı*) : Ön işleme tabi tutulacak video. Piksel değerleri 0 ile 255 arasında değişen tek bir video veya video grubu beklenir. Piksel değerleri 0 ile 1 arasında olan videoları geçiriyorsanız, `do_rescale=False` olarak ayarlayın.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *isteğe bağlı*) : Hazırlanacak ses veya sesler grubu. Her ses, bir NumPy dizisi veya PyTorch tensörü olabilir. NumPy dizisi/PyTorch tensörü durumunda, her sesin şekli (C, T) olmalıdır; burada C kanal sayısı, T ise sesin örnek uzunluğudur.
return_mm_token_type_ids (`bool`, *kwargs*) : Çok modlu yer tutucu token konumlarını gösteren çok modlu token türü kimliklerini döndürüp döndürmeyeceğini belirtir.
return_text_replacement_offsets (`bool`, *kwargs*) : Her çok modlu yer tutucu ve ikamesi için karakter ofsetlerinin döndürülüp döndürülmemesi.
return_tensors (`str` veya [TensorType](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.TensorType), *opsiyonel*) : Ayarlanırsa, belirli bir çerçeveye ait tensörleri döndürür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: NumPy `np.ndarray` nesnelerini döndürür.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/tr/main_classes/processors#transformers.ProcessingKwargs), *opsiyonel*) : Her modalite (metin, görüntüler, videolar, ses) için ek işleme seçenekleri. Modelle ilgili parametreler yukarıda listelenmiştir; desteklenen argümanların tam listesi için TypedDict sınıfına bakın.
## GitModel[[transformers.GitModel]]
#### transformers.GitModel[[transformers.GitModel]]
```python
transformers.GitModel(config: GitConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/git/modeling_git.py#L707)
**Parametreler:**
config ([GitConfig](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Ham GIT Model dönüştürücüsü, ham gizli durumlar (raw hidden-states) üreten bir CLIP görüntü kodlayıcı ve metin çözücüden oluşur
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.GitModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, use_cache: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/git/modeling_git.py#L738)
**Parametreler:**
input_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi token'larının indeksleri. Dolgu (padding) varsayılan olarak yok sayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi ID'leri nelerdir?](../glossary#input-ids)
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
position_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdi dizileri token'larının konum gömme (position embeddings) içindeki konum indeksleri. `[0, config.n_positions - 1]` aralığında seçilir. [Konum kimlikleri (position IDs) nedir?](../glossary#position-ids)
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [CLIPImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/clip#transformers.CLIPImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [CLIPImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([GitProcessor](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitProcessor), görüntü işleme için [CLIPImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/clip#transformers.CLIPImageProcessor) kullanır).
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
past_key_values (`~cache_utils.Cache`, *isteğe bağlı*) : Sıralı çözümlemeyi hızlandırmak için kullanılabilen, önceden hesaplanmış gizli durumlar (self-attention bloklarındaki ve cross-attention bloklarındaki anahtar ve değerler). Bu genellikle, `use_cache=True` veya `config.use_cache=True` olduğunda, çözümlemenin önceki bir aşamasında modelin döndürdüğü `past_key_values` değerlerinden oluşur. Girdi olarak yalnızca [Cache](/docs/transformers/v5.23.0/tr/internal/generation_utils#transformers.Cache) örneği kabul edilir, bkz. [kv cache kılavuzu](https://huggingface.co/docs/transformers/en/kv_cache). `past_key_values` geçirilmezse, varsayılan olarak [DynamicCache](/docs/transformers/v5.23.0/tr/internal/generation_utils#transformers.DynamicCache) başlatılır. Model, girdi olarak verilen aynı önbellek biçimini çıktı olarak verecektir. `past_key_values` kullanılıyorsa, kullanıcının, bu modele geçmiş anahtar-değer durumları verilmemiş olan, yalnızca işlenmemiş `input_ids` değerlerini (şekli `(batch_size, unprocessed_length)` olan) girmesi beklenir; bunun yerine, şekli `(batch_size, sequence_length)` olan tüm `input_ids` değerleri girilmez.
use_cache (`bool`, *isteğe bağlı*) : `True` olarak ayarlanırsa, `past_key_values` anahtar değer durumları döndürülür ve çözümlemeyi hızlandırmak için kullanılabilir (bkz. `past_key_values`).
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([GitConfig](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[GitModel](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base")
>>> model = AutoModel.from_pretrained("microsoft/git-base")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "this is an image of two cats"
>>> inputs = processor(images=image, text=text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
```
## GitForCausalLM[[transformers.GitForCausalLM]]
#### transformers.GitForCausalLM[[transformers.GitForCausalLM]]
```python
transformers.GitForCausalLM(config: GitConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/git/modeling_git.py#L890)
**Parametreler:**
config ([GitConfig](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Otomatik regresif dil modellemesi için üstünde `language modeling` başlığı bulunan GIT Model.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.GitForCausalLM.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, use_cache: bool | None = None, interpolate_pos_encoding: bool = False, logits_to_keep: typing.Union[int, torch.Tensor] = 0, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/git/modeling_git.py#L908)
**Parametreler:**
input_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi token'larının indeksleri. Dolgu (padding) varsayılan olarak yok sayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi ID'leri nelerdir?](../glossary#input-ids)
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
position_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdi dizileri token'larının konum gömme (position embeddings) içindeki konum indeksleri. `[0, config.n_positions - 1]` aralığında seçilir. [Konum kimlikleri (position IDs) nedir?](../glossary#position-ids)
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [CLIPImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/clip#transformers.CLIPImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [CLIPImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([GitProcessor](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitProcessor), görüntü işleme için [CLIPImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/clip#transformers.CLIPImageProcessor) kullanır).
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
labels (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Soldan sağa dil modelleme kaybını (sonraki kelime tahmini) hesaplamak için etiketler. Endeksler `[-100, 0, ..., config.vocab_size]` aralığında olmalıdır (bkz. `input_ids` docstring). Endeksleri `-100` olarak ayarlanan jetonlar yok sayılır (maskelenir), kayıp yalnızca etiketleri `[0, ..., config.vocab_size]` aralığında olan jetonlar için hesaplanır.
past_key_values (`~cache_utils.Cache`, *isteğe bağlı*) : Sıralı çözümlemeyi hızlandırmak için kullanılabilen, önceden hesaplanmış gizli durumlar (self-attention bloklarındaki ve cross-attention bloklarındaki anahtar ve değerler). Bu genellikle, `use_cache=True` veya `config.use_cache=True` olduğunda, çözümlemenin önceki bir aşamasında modelin döndürdüğü `past_key_values` değerlerinden oluşur. Girdi olarak yalnızca [Cache](/docs/transformers/v5.23.0/tr/internal/generation_utils#transformers.Cache) örneği kabul edilir, bkz. [kv cache kılavuzu](https://huggingface.co/docs/transformers/en/kv_cache). `past_key_values` geçirilmezse, varsayılan olarak [DynamicCache](/docs/transformers/v5.23.0/tr/internal/generation_utils#transformers.DynamicCache) başlatılır. Model, girdi olarak verilen aynı önbellek biçimini çıktı olarak verecektir. `past_key_values` kullanılıyorsa, kullanıcının, bu modele geçmiş anahtar-değer durumları verilmemiş olan, yalnızca işlenmemiş `input_ids` değerlerini (şekli `(batch_size, unprocessed_length)` olan) girmesi beklenir; bunun yerine, şekli `(batch_size, sequence_length)` olan tüm `input_ids` değerleri girilmez.
use_cache (`bool`, *isteğe bağlı*) : `True` olarak ayarlanırsa, `past_key_values` anahtar değer durumları döndürülür ve çözümlemeyi hızlandırmak için kullanılabilir (bkz. `past_key_values`).
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
logits_to_keep (`Union[int, torch.Tensor]`, *isteğe bağlı*, varsayılan `0`) : `int` ise, son `logits_to_keep` token için logits hesaplanır. `0` ise, tüm `input_ids` için logits hesaplanır (özel durum). Üretim için yalnızca son token'ın logits'ine ihtiyaç duyulur ve bunların yalnızca o token için hesaplanması bellek tasarrufu sağlar; bu, uzun diziler veya büyük sözlük boyutu için oldukça önemli hale gelir. `torch.Tensor` ise, dizi uzunluğu boyutunda tutulacak indekslere karşılık gelen 1B olmalıdır. Bu, paketlenmiş tensor biçimini (batch ve dizi uzunluğu için tek boyut) kullanırken faydalıdır.
**Dönüş:** [CausalLMOutputWithPast](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithPast) veya `tuple(torch.Tensor)`
[CausalLMOutputWithPast](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithPast) veya `torch.Tensor` bir demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırmaya ([GitConfig](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[GitForCausalLM](/docs/transformers/v5.23.0/tr/model_doc/git#transformers.GitForCausalLM) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Dil modelleme kaybı (sonraki token tahmini için).
- **logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, config.vocab_size)`) -- Dil modelleme başlığının tahmin puanları (SoftMax öncesi her sözlük jetonu için puanlar).
- **past_key_values** (`Cache`, *isteğe bağlı*, `use_cache=True` geçirildiğinde veya `config.use_cache=True` olduğunda döndürülür) -- Bir [Cache](/docs/transformers/v5.23.0/tr/internal/generation_utils#transformers.Cache) örneğidir. Daha fazla ayrıntı için [kv cache kılavuzumuza](https://huggingface.co/docs/transformers/en/kv_cache) bakın.
Sıralı çözümlemeyi hızlandırmak için (bkz. `past_key_values` girdisi) kullanılabilen, önceden hesaplanmış gizli durumları (self-attention bloklarındaki anahtar ve değerler) içerir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
Görüntü açıklama örneği:
```python
>>> from transformers import AutoProcessor, AutoModelForCausalLM
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base-coco")
>>> model = AutoModelForCausalLM.from_pretrained("microsoft/git-base-coco")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> pixel_values = processor(images=image, return_tensors="pt").pixel_values
>>> generated_ids = model.generate(pixel_values=pixel_values, max_length=50)
>>> generated_caption = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
>>> print(generated_caption)
two cats sleeping on a pink blanket next to remotes.
```
Görsel soru yanıtlama (VQA) örneği:
```python
>>> from transformers import AutoProcessor, AutoModelForCausalLM
>>> from huggingface_hub import hf_hub_download
>>> from PIL import Image
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base-textvqa")
>>> model = AutoModelForCausalLM.from_pretrained("microsoft/git-base-textvqa")
>>> file_path = hf_hub_download(repo_id="nielsr/textvqa-sample", filename="bus.png", repo_type="dataset")
>>> image = Image.open(file_path).convert("RGB")
>>> pixel_values = processor(images=image, return_tensors="pt").pixel_values
>>> question = "what does the front of the bus say at the top?"
>>> input_ids = processor(text=question, add_special_tokens=False).input_ids
>>> input_ids = [processor.tokenizer.cls_token_id] + input_ids
>>> input_ids = torch.tensor(input_ids).unsqueeze(0)
>>> generated_ids = model.generate(pixel_values=pixel_values, input_ids=input_ids, max_length=50)
>>> print(processor.batch_decode(generated_ids, skip_special_tokens=True))
['what does the front of the bus say at the top? special']
```
Video açıklama örneği:
```python
>>> import av
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub import hf_hub_download
>>> from transformers import AutoProcessor, AutoModelForCausalLM
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base-vatex")
>>> model = AutoModelForCausalLM.from_pretrained("microsoft/git-base-vatex")
>>> # set seed for reproducibility
>>> np.random.seed(45)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # load video
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample frames
>>> num_frames = model.config.num_image_with_embedding
>>> indices = sample_frame_indices(
... clip_len=num_frames, frame_sample_rate=4, seg_len=container.streams.video[0].frames
... )
>>> frames = read_video_pyav(container, indices)
>>> pixel_values = processor(images=list(frames), return_tensors="pt").pixel_values
>>> generated_ids = model.generate(pixel_values=pixel_values, max_length=50)
>>> print("Generated caption:", processor.batch_decode(generated_ids, skip_special_tokens=True))
Generated caption: ['a woman is sitting at a table and she is talking about the food she is holding.']
```