# LLaVa
## Обзор
LLaVa — это открытый чат-бот, обученный методом дообучения LlamA/Vicuna на мультимодальных данных для следования инструкциям, сгенерированных GPT. Это авто-регрессионная языковая модель, основанная на архитектуре трансформера. Иными словами, это мультимодальная версия LLM, дообученная для чата и следования инструкциям.
Модель LLaVa была предложена в работе [Visual Instruction Tuning](https://huggingface.co/papers/2304.08485) и улучшена в работе [Improved Baselines with Visual Instruction Tuning](https://huggingface.co/papers/2310.03744) Хаотяня Лю, Чуньюаня Ли, Юхэнга Ли и Ёна Дже Ли.
Аннотация из статьи следующая:
*Large multimodal models (LMM) have recently shown encouraging progress with visual instruction tuning. In this note, we show that the fully-connected vision-language cross-modal connector in LLaVA is surprisingly powerful and data-efficient. With simple modifications to LLaVA, namely, using CLIP-ViT-L-336px with an MLP projection and adding academic-task-oriented VQA data with simple response formatting prompts, we establish stronger baselines that achieve state-of-the-art across 11 benchmarks. Our final 13B checkpoint uses merely 1.2M publicly available data, and finishes full training in ∼1 day on a single 8-A100 node. We hope this can make state-of-the-art LMM research more accessible. Code and model will be publicly available*
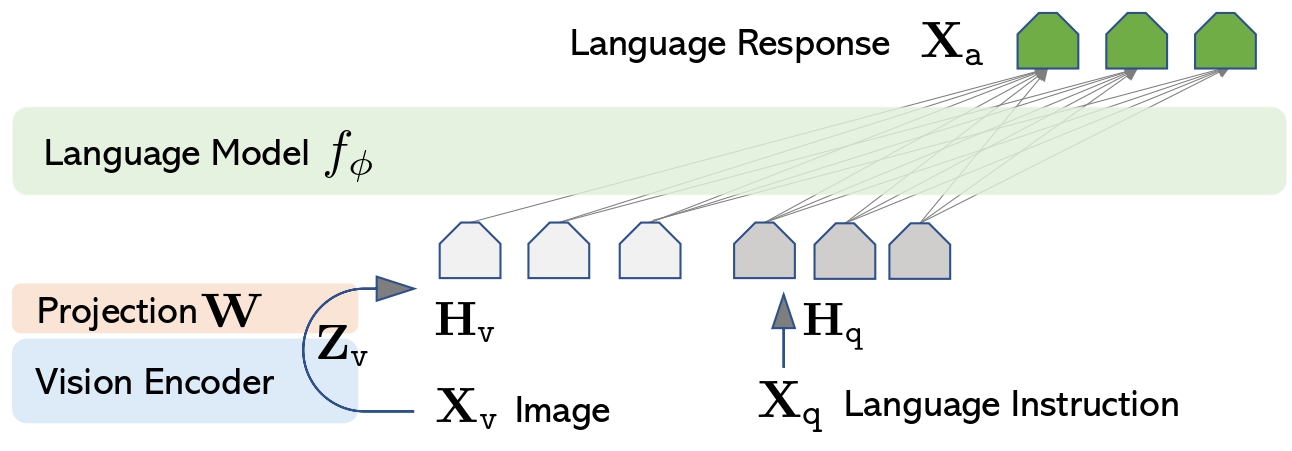 Архитектура LLaVa. Взята из оригинальной статьи.
Эта модель была добавлена [ArthurZ](https://huggingface.co/ArthurZ) и [ybelkada](https://huggingface.co/ybelkada). Исходный код можно найти [здесь](https://github.com/haotian-liu/LLaVA/tree/main/llava).
> [!TIP]
> Установите `use_kernels=True` в [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained), чтобы заменить поддерживаемые слои на оптимизированные ядра из Hub. Подробнее см. в разделе [Загрузка ядер](../kernel_doc/loading_kernels).
## Советы по использованию
- Мы рекомендуем пользователям использовать `padding_side="left"` при вычислении пакетной генерации, так как это приводит к более точным результатам. Просто убедитесь, что вы вызываете `processor.tokenizer.padding_side = "left"` перед генерацией.
- Обратите внимание, что модель не была явно обучена для обработки нескольких изображений в одном запросе. Хотя технически это возможно, результаты могут быть неточными.
> [!NOTE]
> Модели LLaVA после выпуска v4.46 будут выдавать предупреждения о добавлении `processor.patch_size = {{patch_size}}`, `processor.num_additional_image_tokens = {{num_additional_image_tokens}}` и `processor.vision_feature_select_strategy = {{vision_feature_select_strategy}}`. Если вы являетесь владельцем контрольной точки модели, настоятельно рекомендуется добавить эти атрибуты в процессор; если же она вам не принадлежит, создайте pull request.
Добавление этих атрибутов означает, что LLaVA будет пытаться определить количество токенов изображений, необходимых на каждое изображение, и расширить текст таким количеством плейсхолдеров ``, сколько будет токенов. Обычно это около 500 токенов на изображение, поэтому убедитесь, что текст не обрезается, иначе произойдёт сбой при объединении эмбеддингов. Атрибуты можно получить из конфигурации модели, например, как `model.config.vision_config.patch_size` или `model.config.vision_feature_select_strategy`. Значение `num_additional_image_tokens` должно быть `1`, если визуальный бэкбон добавляет CLS-токен, или `0`, если к визуальным патчам ничего дополнительного не добавляется.
### Форматирование промптов с помощью шаблонов чата
Каждый **чекпоинт** обучен с использованием конкретного формата промпта, который зависит от базовой архитектуры большой языковой модели. Для обеспечения корректного форматирования используйте метод `apply_chat_template` процессора.
**Важно:**
- Необходимо сформировать историю диалога — передача обычной строки не сработает.
- Каждое сообщение должно быть словарем с ключами `"role"` и `"content"`.
- `"content"` должен представлять собой список словарей для различных модальностей, таких как `"text"` и `"image"`.
Ниже приведен пример структуры входных данных. Мы будем использовать [llava-hf/llava-1.5-7b-hf](https://huggingface.co/llava-hf/llava-1.5-7b-hf) и историю диалога, содержащую текст и изображение. Каждое поле content должно быть списком словарей, как показано ниже:
```python
from transformers import AutoProcessor
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
conversation = [
{
"role": "user",
"content": [
{"type": "image"},
{"type": "text", "text": "What’s shown in this image?"},
],
},
{
"role": "assistant",
"content": [{"type": "text", "text": "This image shows a red stop sign."},]
},
{
"role": "user",
"content": [
{"type": "text", "text": "Describe the image in more details."},
],
},
]
text_prompt = processor.apply_chat_template(conversation, add_generation_prompt=True)
# Note that the template simply formats your prompt, you still have to tokenize it and obtain pixel values for your images
print(text_prompt)
"USER: \nUSER: Describe the image in more details. ASSISTANT:"
```
- Если вы хотите самостоятельно составить промпт для чата, ниже приведён список форматов промптов, поддерживаемых каждой контрольной точкой llava:
Моделям [llava-interleave](https://huggingface.co/collections/llava-hf/llava-interleave-668e19a97da0036aad4a2f19) требуется следующий формат:
```bash
"<|im_start|>user \nWhat is shown in this image?<|im_end|><|im_start|>assistant"
```
Для диалога в несколько ходов:
```bash
"<|im_start|>user \n<|im_end|><|im_start|>assistant <|im_end|><|im_start|>user \n<|im_end|><|im_start|>assistant "
```
Моделям [llava-1.5](https://huggingface.co/collections/llava-hf/llava-15-65f762d5b6941db5c2ba07e0) требуется следующий формат:
```bash
"USER: \n ASSISTANT:"
```
Для диалога в несколько ходов:
```bash
"USER: \n ASSISTANT: USER: ASSISTANT: USER: ASSISTANT:"
```
🚀 **Бонус:** если вы используете `transformers>=4.49.0`, вы также можете получить векторизованный вывод из `apply_chat_template`. Подробнее о том, как это сделать, см. в разделе **Примеры использования** ниже.
## Примеры использования
### Вывод для одного входа
```python
import torch
from transformers import AutoProcessor, LlavaForConditionalGeneration
# Load the model in half-precision
model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf", device_map="auto")
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
conversation = [
{
"role": "user",
"content": [
{"type": "image", "url": "https://www.ilankelman.org/stopsigns/australia.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
inputs = processor.apply_chat_template(
conversation,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt"
).to(model.device, torch.float16)
# Generate
generate_ids = model.generate(**inputs, max_new_tokens=30)
processor.batch_decode(generate_ids, skip_special_tokens=True)
```
### Пакетный вывод
LLaVa также поддерживает пакетный вывод. Вот как это можно сделать:
```python
import torch
from transformers import AutoProcessor, LlavaForConditionalGeneration
# Load the model in half-precision
model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf", device_map="auto")
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
# Prepare a batch of two prompts
conversation_1 = [
{
"role": "user",
"content": [
{"type": "image", "url": "https://www.ilankelman.org/stopsigns/australia.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
conversation_2 = [
{
"role": "user",
"content": [
{"type": "image", "url": "http://images.cocodataset.org/val2017/000000039769.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
inputs = processor.apply_chat_template(
[conversation_1, conversation_2],
add_generation_prompt=True,
tokenize=True,
return_dict=True,
padding=True,
return_tensors="pt"
).to(model.device, torch.float16)
# Generate
generate_ids = model.generate(**inputs, max_new_tokens=30)
processor.batch_decode(generate_ids, skip_special_tokens=True)
```
## Примечание о воспроизведении исходной реализации
Чтобы логиты совпадали с [исходной реализацией](https://github.com/haotian-liu/LLaVA/tree/main), при создании экземпляра `LlavaImageProcessor` необходимо дополнительно указать `do_pad=True`:
```python
from transformers import LlavaImageProcessor
image_processor = LlavaImageProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf", do_pad=True)
```
### Использование Flash Attention 2
Flash Attention 2 — это ещё более быстрая, оптимизированная версия предыдущего оптимизационного решения; см. раздел [Flash Attention 2 в документации по производительности](https://huggingface.co/docs/transformers/perf_infer_gpu_one).
## Ресурсы
Список официальных ресурсов Hugging Face и сообщества (отмечены значком 🌎), которые помогут вам начать работу с LLaVa.
- Демо на [Google Colab](https://colab.research.google.com/drive/1qsl6cd2c8gGtEW1xV5io7S8NHh-Cp1TV?usp=sharing) с примером запуска Llava на бесплатном экземпляре Google Colab с использованием 4-битного вывода.
- [Похожий ноутбук](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/LLaVa/Inference_with_LLaVa_for_multimodal_generation.ipynb) с демонстрацией пакетного вывода. 🌎
## LlavaConfig[[transformers.LlavaConfig]]
#### transformers.LlavaConfig[[transformers.LlavaConfig]]
```python
transformers.LlavaConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, image_token_index: int = 32000, image_seq_length: int = 576, projector_hidden_act: str = 'gelu', vision_feature_select_strategy: typing.Literal['default', 'full'] = 'default', vision_feature_layer: int | list[int] = -2, multimodal_projector_bias: bool = True, tie_word_embeddings: bool = False)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/configuration_llava.py#L26)
**Параметры:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Объект конфигурации или словарь для визуального бэкбона.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Объект конфигурации или словарь текстового бэкбона.
image_token_index (`int`, *необязательный*, по умолчанию `32000`) : Индекс токена изображения, используемый как плейсхолдер для входных изображений.
image_seq_length (`int`, *optional*, по умолчанию `576`) : Длина последовательности одного эмбеддинга изображения.
projector_hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Функция активации, используемая мультимодальным проектором.
vision_feature_select_strategy (`Literal[default, full]`, *необязательный*, по умолчанию `default`) : Стратегия отбора признаков, используемая для выбора визуального признака из визуального базового блока.
vision_feature_layer (`Union[int, list[int]]`, *необязательный*, по умолчанию `-2`) : Индекс слоя, из которого извлекаются визуальные признаки. Если указано несколько индексов, визуальные признаки соответствующих индексов будут объединены в один набор визуальных признаков.
multimodal_projector_bias (`bool`, *необязательный*, по умолчанию `True`) : Использовать ли смещение (bias) в мультимодальном проекторе.
tie_word_embeddings (`bool`, *необязательный*, по умолчанию `False`) : Связывать ли веса эмбеддингов согласно отображению `tied_weights_keys` модели.
Это класс конфигурации для хранения настроек модели LlavaModel. Он используется для создания модели Llava в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [llava-hf/llava-1.5-7b-hf](https://huggingface.co/llava-hf/llava-1.5-7b-hf)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import LlavaForConditionalGeneration, LlavaConfig, CLIPVisionConfig, LlamaConfig
>>> # Initializing a CLIP-vision config
>>> vision_config = CLIPVisionConfig()
>>> # Initializing a Llama config
>>> text_config = LlamaConfig()
>>> # Initializing a Llava llava-1.5-7b style configuration
>>> configuration = LlavaConfig(vision_config, text_config)
>>> # Initializing a model from the llava-1.5-7b style configuration
>>> model = LlavaForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## LlavaImageProcessor[[transformers.LlavaImageProcessor]]
#### transformers.LlavaImageProcessor[[transformers.LlavaImageProcessor]]
```python
transformers.LlavaImageProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/image_processing_llava.py#L38)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*, по умолчанию `True`) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 224}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 224, 'width': 224}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `3`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Влияет только в том случае, если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.48145466, 0.4578275, 0.40821073]`) : Среднее значение изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.26862954, 0.26130258, 0.27577711]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Нужно ли добавлять отступы к изображению. Отступы добавляются либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия добавления отступов зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
Создает процессор изображений LlavaImageProcessor.
#### preprocess[[transformers.LlavaImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *необязательный*) : Флаг разработчика для дополнительных изображений и похожих на них входных данных, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например, `preprocess(images, masks=masks)` — предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использовать `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
## LlavaImageProcessorPil[[transformers.LlavaImageProcessorPil]]
#### transformers.LlavaImageProcessorPil[[transformers.LlavaImageProcessorPil]]
```python
transformers.LlavaImageProcessorPil(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/image_processing_pil_llava.py#L31)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*, по умолчанию `True`) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 224}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 224, 'width': 224}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `3`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Влияет только в том случае, если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.48145466, 0.4578275, 0.40821073]`) : Среднее значение изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.26862954, 0.26130258, 0.27577711]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Нужно ли добавлять отступы к изображению. Отступы добавляются либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия добавления отступов зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
Создает процессор изображений LlavaImageProcessor.
#### preprocess[[transformers.LlavaImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *необязательный*) : Флаг разработчика для дополнительных изображений и похожих на них входных данных, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например, `preprocess(images, masks=masks)` — предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использовать `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
## LlavaProcessor[[transformers.LlavaProcessor]]
#### transformers.LlavaProcessor[[transformers.LlavaProcessor]]
```python
transformers.LlavaProcessor(image_processor = None, tokenizer = None, patch_size = None, vision_feature_select_strategy = None, chat_template = None, image_token = '', num_additional_image_tokens = 0, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/processing_llava.py#L32)
**Параметры:**
image_processor (`LlavaImageProcessor`) : процессор изображений является обязательным входным параметром.
tokenizer (`TokenizersBackend`) : Токенизатор является обязательным входным параметром.
patch_size (`int`, *необязательный*) : Размер патча из визуальной башни.
vision_feature_select_strategy (`str`, *необязательный*) : Стратегия отбора признаков, используемая для выбора визуальных признаков из визуального базового блока. Должна совпадать с настройкой модели
chat_template (`str`) : Шаблон Jinja для преобразования списков сообщений в чате в строку, готовую к токенизации.
image_token (`str`, *необязательный*, по умолчанию `""`) : Специальный токен, используемый для обозначения местоположения изображения.
num_additional_image_tokens (`int`, *optional*, по умолчанию 0) : Количество дополнительных токенов, добавляемых к эмбеддингам изображения, например CLS (+1). Если у backbone нет CLS или других дополнительных токенов, нет необходимости задавать этот аргумент.
Создаёт LlavaProcessor, который объединяет image processor и tokenizer в единый processor.
[LlavaProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaProcessor) предоставляет все возможности [LlavaImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaImageProcessor) и [TokenizersBackend](/docs/transformers/v5.23.0/ru/main_classes/tokenizer#transformers.TokenizersBackend). Подробнее см. в [~LlavaImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaImageProcessor) и [~TokenizersBackend](/docs/transformers/v5.23.0/ru/main_classes/tokenizer#transformers.TokenizersBackend).
#### __call__[[transformers.LlavaProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *необязательный*) : Изображение для предварительной обработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *необязательный*) : Последовательность или батч последовательностей для кодирования. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если вы передаёте предтокенизированный вход, установите `is_split_into_words=True`, чтобы избежать неоднозначности с батчированными входами.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *optional*) : Видео для предобработки. Ожидается одно видео или батч видео со значениями пикселей в диапазоне от 0 до 255. Если передаются видео со значениями пикселей от 0 до 1, установите `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *необязательный*) : Аудио или пакет аудио для подготовки. Каждое аудио может быть массивом NumPy или тензором PyTorch. В случае массива NumPy/тензора PyTorch каждое аудио должно иметь форму (C, T), где C — количество каналов, а T — длина выборки аудио.
return_mm_token_type_ids (`bool`, *kwargs*) : Нужно ли возвращать идентификаторы типов мультимодальных токенов, указывающие на позиции мультимодальных плейсхолдер-токенов.
return_text_replacement_offsets (`bool`, *kwargs*) : Нужно ли возвращать смещения символов для каждого мультимодального плейсхолдера и его замены.
return_tensors (`str` или [TensorType](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры конкретного фреймворка. Допустимые значения: - `'pt'`: возвращает объекты `torch.Tensor` PyTorch. - `'np'`: возвращает объекты `np.ndarray` NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/ru/main_classes/processors#transformers.ProcessingKwargs), *optional*) : Дополнительные параметры обработки для каждой модальности (текст, изображения, видео, аудио). Специфичные для модели параметры перечислены выше; полный список поддерживаемых аргументов см. в классе TypedDict.
## LlavaModel[[transformers.LlavaModel]]
#### transformers.LlavaModel[[transformers.LlavaModel]]
```python
transformers.LlavaModel(config: LlavaConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L131)
**Параметры:**
config ([LlavaConfig](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaConfig)) : класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Llava, состоящая из визуального бэкбона и языковой модели, без головы для моделирования языка.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.LlavaModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, image_sizes: typing.Optional[torch.Tensor] = None, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L216)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [LlavaImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaImageProcessor). Подробности см. в [LlavaImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([LlavaProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaProcessor) использует [LlavaImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaImageProcessor) для обработки изображений).
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
position_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона `[0, config.n_positions - 1]`. [Что такое position IDs?](../glossary#position-ids)
past_key_values (`~cache_utils.Cache`, *необязательный*) : Предварительно вычисленные скрытые состояния (ключи и значения в блоках само-внимания и кросс-внимания), которые можно использовать для ускорения последовательного декодирования. Обычно это `past_key_values`, возвращаемые моделью на предыдущем этапе декодирования, когда `use_cache=True` или `config.use_cache=True`. В качестве входного значения допускается только экземпляр [Cache](/docs/transformers/v5.23.0/ru/internal/generation_utils#transformers.Cache), см. наше [руководство по kv cache](https://huggingface.co/docs/transformers/en/kv_cache). Если `past_key_values` не переданы, по умолчанию будет инициализирован [DynamicCache](/docs/transformers/v5.23.0/ru/internal/generation_utils#transformers.DynamicCache). Модель будет выводить тот же формат кэша, который был передан на вход. Если используются `past_key_values`, ожидается, что пользователь передаст только необработанные `input_ids` (те, для которых не заданы их прошлые состояния ключей и значений в этой модели) с формой `(batch_size, unprocessed_length)` вместо всех `input_ids` с формой `(batch_size, sequence_length)`.
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи `input_ids` можно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексы `input_ids` преобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели.
vision_feature_layer (`Union[int, list[int]]`, *необязательный*) : Индекс слоя, из которого извлекаются визуальные признаки. Если указано несколько индексов, визуальные признаки соответствующих индексов будут объединены в один набор визуальных признаков.
vision_feature_select_strategy (`str`, *необязательный*) : Стратегия отбора признаков, используемая для выбора визуальных признаков из визуального базового блока. Может принимать значение `"default"` или `"full"`.
image_sizes (`torch.Tensor` формы `(batch_size, 2)`, *необязательный*) : Размеры изображений в батче, представленные как (высота, ширина) для каждого изображения.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *необязательный*) : Словарь, где ключами являются поддерживаемые модальности, а значениями — закодированные выходные данные для данной модальности. Каждый закодированный выход представляет собой кортеж, состоящий из (`pooler_output`, *необязательный*: `last_hidden_states`, *необязательный*: `hidden_states`, *необязательный*: `attentions`) `pooler_output` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) — это последовательность мультимодальных признаков энкодера, объединенных в текстовые эмбеддинги.
**Возвращает:** `LlavaModelOutputWithPast` или `tuple(torch.Tensor)`
Объект `LlavaModelOutputWithPast` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([LlavaConfig](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaConfig)) и входных данных.
Метод forward модели [LlavaModel](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
Если используется `past_key_values`, выводится только последнее скрытое состояние последовательностей формы `(batch_size, 1, hidden_size)`.
- **past_key_values** (`Cache`, *необязательный*, возвращается при передаче `use_cache=True` или когда `config.use_cache=True`) -- это экземпляр [Cache](/docs/transformers/v5.23.0/ru/internal/generation_utils#transformers.Cache). Подробнее см. в нашем [руководстве по кэшированию kv](https://huggingface.co/docs/transformers/en/kv_cache).
Содержит предварительно вычисленные скрытые состояния (ключи и значения в блоках само-внимания), которые можно использовать (см. вход `past_key_values`) для ускорения последовательного декодирования.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **image_hidden_states** (`torch.Tensor`, *необязательный*) -- `torch.Tensor` размера `(batch_size, num_images, sequence_length, hidden_size)`. image_hidden_states модели, полученные визуальным энкодером после проекции последнего скрытого состояния.
#### get_image_features[[transformers.LlavaModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, image_sizes: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L140)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [LlavaImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaImageProcessor). Подробности см. в [LlavaImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([LlavaProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaProcessor) использует [LlavaImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaImageProcessor) для обработки изображений).
vision_feature_layer (`Union[int, list[int]]`, *необязательный*) : Индекс слоя, из которого извлекаются визуальные признаки. Если указано несколько индексов, визуальные признаки соответствующих индексов будут объединены в один набор визуальных признаков.
vision_feature_select_strategy (`str`, *необязательный*) : Стратегия отбора признаков, используемая для выбора визуальных признаков из визуального базового блока. Может принимать значение `"default"` или `"full"`.
image_sizes (`torch.Tensor` формы `(batch_size, 2)`, *необязательный*) : Размеры изображений в батче, представленные как (высота, ширина) для каждого изображения.
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([LlavaConfig](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaConfig)) и входных данных.
Получает последние скрытые состояния изображений из визуальной башни и применяет мультимодальную проекцию.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
#### get_placeholder_mask[[transformers.LlavaModel.get_placeholder_mask]]
```python
get_placeholder_mask(input_ids: LongTensor, inputs_embeds: Tensor, image_features: Tensor)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L192)
Получает маску мультимодальных плейсхолдеров из `input_ids` или `inputs_embeds` и проверяет, что количество плейсхолдер-токенов равно длине мультимодальных признаков. Если длины различаются, возникает ошибка.
## LlavaForConditionalGeneration[[transformers.LlavaForConditionalGeneration]]
#### transformers.LlavaForConditionalGeneration[[transformers.LlavaForConditionalGeneration]]
```python
transformers.LlavaForConditionalGeneration(config: LlavaConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L281)
**Параметры:**
config ([LlavaConfig](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaConfig)) : класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель LLAVA, состоящая из визуального бэкбона и языковой модели.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.LlavaForConditionalGeneration.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, labels: typing.Optional[torch.LongTensor] = None, logits_to_keep: typing.Union[int, torch.Tensor] = 0, image_sizes: typing.Optional[torch.Tensor] = None, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L309)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [LlavaImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaImageProcessor). Подробности см. в [LlavaImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([LlavaProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaProcessor) использует [LlavaImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaImageProcessor) для обработки изображений).
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
position_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона `[0, config.n_positions - 1]`. [Что такое position IDs?](../glossary#position-ids)
past_key_values (`~cache_utils.Cache`, *необязательный*) : Предварительно вычисленные скрытые состояния (ключи и значения в блоках само-внимания и кросс-внимания), которые можно использовать для ускорения последовательного декодирования. Обычно это `past_key_values`, возвращаемые моделью на предыдущем этапе декодирования, когда `use_cache=True` или `config.use_cache=True`. В качестве входного значения допускается только экземпляр [Cache](/docs/transformers/v5.23.0/ru/internal/generation_utils#transformers.Cache), см. наше [руководство по kv cache](https://huggingface.co/docs/transformers/en/kv_cache). Если `past_key_values` не переданы, по умолчанию будет инициализирован [DynamicCache](/docs/transformers/v5.23.0/ru/internal/generation_utils#transformers.DynamicCache). Модель будет выводить тот же формат кэша, который был передан на вход. Если используются `past_key_values`, ожидается, что пользователь передаст только необработанные `input_ids` (те, для которых не заданы их прошлые состояния ключей и значений в этой модели) с формой `(batch_size, unprocessed_length)` вместо всех `input_ids` с формой `(batch_size, sequence_length)`.
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи `input_ids` можно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексы `input_ids` преобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели.
vision_feature_layer (`Union[int, list[int]]`, *необязательный*) : Индекс слоя, из которого извлекаются визуальные признаки. Если указано несколько индексов, визуальные признаки соответствующих индексов будут объединены в один набор визуальных признаков.
vision_feature_select_strategy (`str`, *необязательный*) : Стратегия отбора признаков, используемая для выбора визуальных признаков из визуального базового блока. Может принимать значение `"default"` или `"full"`.
labels (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Метки для вычисления потерь маскированного языкового моделирования. Индексы должны находиться в диапазоне `[0, ..., config.vocab_size]` или равняться -100 (см. docstring `input_ids`). Токены с индексами, установленными в `-100`, игнорируются (маскируются); потери вычисляются только для токенов с метками в диапазоне `[0, ..., config.vocab_size]`.
logits_to_keep (`Union[int, torch.Tensor]`, *необязательный*, по умолчанию `0`) : Если передано значение типа `int`, вычисляются logits для последних `logits_to_keep` токенов. Если передано `0`, logits вычисляются для всех `input_ids` (специальный случай). Для генерации нужны logits только последнего токена, и вычисление их только для этого токена позволяет сэкономить память, что становится весьма значимым для длинных последовательностей или большого размера словаря. Если передано значение типа `torch.Tensor`, оно должно быть одномерным и соответствовать индексам, которые нужно сохранить в измерении длины последовательности. Это полезно при использовании упакованного формата тензоров (одно измерение для batch и длины последовательности).
image_sizes (`torch.Tensor` формы `(batch_size, 2)`, *необязательный*) : Размеры изображений в батче, представленные как (высота, ширина) для каждого изображения.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *необязательный*) : Словарь, где ключами являются поддерживаемые модальности, а значениями — закодированные выходные данные для данной модальности. Каждый закодированный выход представляет собой кортеж, состоящий из (`pooler_output`, *необязательный*: `last_hidden_states`, *необязательный*: `hidden_states`, *необязательный*: `attentions`) `pooler_output` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) — это последовательность мультимодальных признаков энкодера, объединенных в текстовые эмбеддинги.
**Возвращает:** `LlavaCausalLMOutputWithPast` или `tuple(torch.Tensor)`
Объект `LlavaCausalLMOutputWithPast` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([LlavaConfig](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaConfig)) и входных данных.
Метод forward класса [LlavaForConditionalGeneration](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaForConditionalGeneration) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потеря языковой модели (для предсказания следующего токена).
- **logits** (`torch.Tensor` формы `(batch_size, sequence_length, config.vocab_size)`) — Оценки предсказаний языковой модели (оценки для каждого токена словаря до применения SoftMax).
- **past_key_values** (`Cache`, *необязательный*, возвращается при передаче `use_cache=True` или когда `config.use_cache=True`) -- это экземпляр [Cache](/docs/transformers/v5.23.0/ru/internal/generation_utils#transformers.Cache). Подробнее см. в нашем [руководстве по кэшированию kv](https://huggingface.co/docs/transformers/en/kv_cache).
Содержит предварительно вычисленные скрытые состояния (ключи и значения в блоках само-внимания), которые можно использовать (см. вход `past_key_values`) для ускорения последовательного декодирования.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **image_hidden_states** (`torch.Tensor`, *необязательный*) -- `torch.Tensor` размера `(batch_size, num_images, sequence_length, hidden_size)`. image_hidden_states модели, полученные визуальным энкодером после проекции последнего скрытого состояния.
Пример:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, LlavaForConditionalGeneration
>>> model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> prompt = "USER: \nWhat's the content of the image? ASSISTANT:"
>>> url = "https://www.ilankelman.org/stopsigns/australia.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, text=prompt, return_tensors="pt")
>>> # Generate
>>> generate_ids = model.generate(**inputs, max_new_tokens=15)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"USER: \nWhat's the content of the image? ASSISTANT: The image features a busy city street with a stop sign prominently displayed"
```
#### get_image_features[[transformers.LlavaForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L294)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [LlavaImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaImageProcessor). Подробности см. в [LlavaImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([LlavaProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaProcessor) использует [LlavaImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaImageProcessor) для обработки изображений).
vision_feature_layer (`Union[int, list[int]]`, *необязательный*) : Индекс слоя, из которого извлекаются визуальные признаки. Если указано несколько индексов, визуальные признаки соответствующих индексов будут объединены в один набор визуальных признаков.
vision_feature_select_strategy (`str`, *необязательный*) : Стратегия отбора признаков, используемая для выбора визуальных признаков из визуального базового блока. Может принимать значение `"default"` или `"full"`.
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([LlavaConfig](/docs/transformers/v5.23.0/ru/model_doc/llava#transformers.LlavaConfig)) и входных данных.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Пример:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, LlavaForConditionalGeneration
>>> model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```