# BEiT
## Aperçu
Le modèle BEiT a été proposé dans [BEiT: BERT Pre-Training of Image Transformers](https://huggingface.co/papers/2106.08254) par Hangbo Bao, Li Dong et Furu Wei. Inspiré de BERT, BEiT est le premier article à démontrer que le pré-entraînement auto-supervisé des Vision Transformers (ViTs) surpasse le pré-entraînement supervisé. Plutôt que de pré-entraîner le modèle à prédire la classe d'une image (comme c'est fait dans l'[article original sur ViT](https://huggingface.co/papers/2010.11929)), les modèles BEiT sont pré-entraînés à prédire des jetons visuels à partir du codebook du modèle [DALL-E](https://huggingface.co/papers/2102.12092) d'OpenAI, à partir de patches masqués.
L'abstract de l'article est le suivant :
*Nous présentons BEiT, un modèle de représentation visuelle auto-supervisé, dont l'acronyme signifie Bidirectional Encoder representation from Image Transformers. En suivant l'approche de BERT développée dans le domaine du traitement automatique du langage, nous proposons une tâche de modélisation d'images masquées pour pré-entraîner des Transformers visuels. Plus précisément, chaque image dispose de deux vues lors de notre pré-entraînement, à savoir des patches d'image (par exemple, 16x16 pixels) et des jetons visuels (c'est-à-dire des jetons discrets). Nous « tokenisons » d'abord l'image d'origine en jetons visuels. Ensuite, nous masquons aléatoirement certains patches d'image et les fournissons au Transformer de base. L'objectif du pré-entraînement est de récupérer les jetons visuels d'origine à partir des patches d'image corrompus. Après le pré-entraînement de BEiT, nous affinons directement les paramètres du modèle sur les tâches en aval en ajoutant des couches de tâche sur l'encodeur pré-entraîné. Les résultats expérimentaux sur la classification d'images et la segmentation sémantique montrent que notre modèle obtient des résultats compétitifs par rapport aux méthodes de pré-entraînement précédentes. Par exemple, BEiT de taille base atteint une précision top-1 de 83,2 % sur ImageNet-1K, surpassant nettement l'entraînement DeiT depuis zéro (81,8 %) avec la même configuration. De plus, BEiT de taille grande obtient 86,3 % en utilisant uniquement ImageNet-1K, surpassant même ViT-L avec un pré-entraînement supervisé sur ImageNet-22K (85,2 %).*
Ce modèle a été contribué par [nielsr](https://huggingface.co/nielsr). Le code d'origine peut être trouvé [ici](https://github.com/microsoft/unilm/tree/master/beit).
## Conseils d'utilisation
- Les modèles BEiT sont des Vision Transformers classiques, mais pré-entraînés de manière auto-supervisée plutôt que supervisée. Ils surpassent à la fois le [modèle d’origine (ViT)](vit) et [Data-efficient Image Transformers (DeiT)](deit) lors de l’ajustement fin sur ImageNet-1K et CIFAR-100. Vous pouvez consulter des notebooks de démonstration concernant l’inférence ainsi que l’ajustement fin sur des données personnalisées [ici](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/VisionTransformer) (il suffit de remplacer [ViTImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/vit#transformers.ViTImageProcessor) par [BeitImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitImageProcessor) et [ViTForImageClassification](/docs/transformers/v5.23.0/fr/model_doc/vit#transformers.ViTForImageClassification) par [BeitForImageClassification](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitForImageClassification)).
- Un notebook de démonstration est également disponible, qui montre comment combiner le tokenizer d'images de DALL-E avec BEiT pour effectuer du masked image modeling. Vous pouvez le trouver [ici](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/BEiT).
- Les modèles BEiT s'attendant à ce que chaque image ait la même taille (résolution), on peut utiliser [BeitImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitImageProcessor) pour redimensionner (ou remasquer) et normaliser les images pour le modèle.
- La résolution des patches et la résolution des images utilisées lors de la pré-entraînement ou de l'ajustement fin sont toutes deux reflétées dans le nom de chaque point de contrôle. Par exemple, `microsoft/beit-base-patch16-224` désigne une architecture de taille de base avec une résolution de patch de 16x16 et une résolution d'ajustement fin de 224x224. Tous les points de contrôle sont disponibles sur le [hub](https://huggingface.co/models?search=microsoft/beit).
- Les points de contrôle disponibles sont soit (1) pré-entraînés uniquement sur [ImageNet-22k](http://www.image-net.org/) (un ensemble de 14 millions d’images et 22k classes), (2) également affinés sur ImageNet-22k, ou (3) également affinés sur [ImageNet-1k](http://www.image-net.org/challenges/LSVRC/2012/) (également appelé ILSVRC 2012, un ensemble de 1,3 million d’images et 1 000 classes).
- BEiT utilise des embeddings de position relative, inspirés du modèle T5. Lors de la pré-entraînement, les auteurs ont partagé le biais de position relative entre les différentes couches d'auto-attention. Lors de l'ajustement fin, le biais de position relative de chaque couche est initialisé avec le biais de position relative partagé obtenu après la pré-entraînement. Notez que, si l'on souhaite pré-entraîner un modèle à partir de zéro, il est nécessaire de définir l'attribut `use_relative_position_bias` ou `use_relative_position_bias` de [BeitConfig](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitConfig) sur `True` afin d'ajouter des embeddings de position.
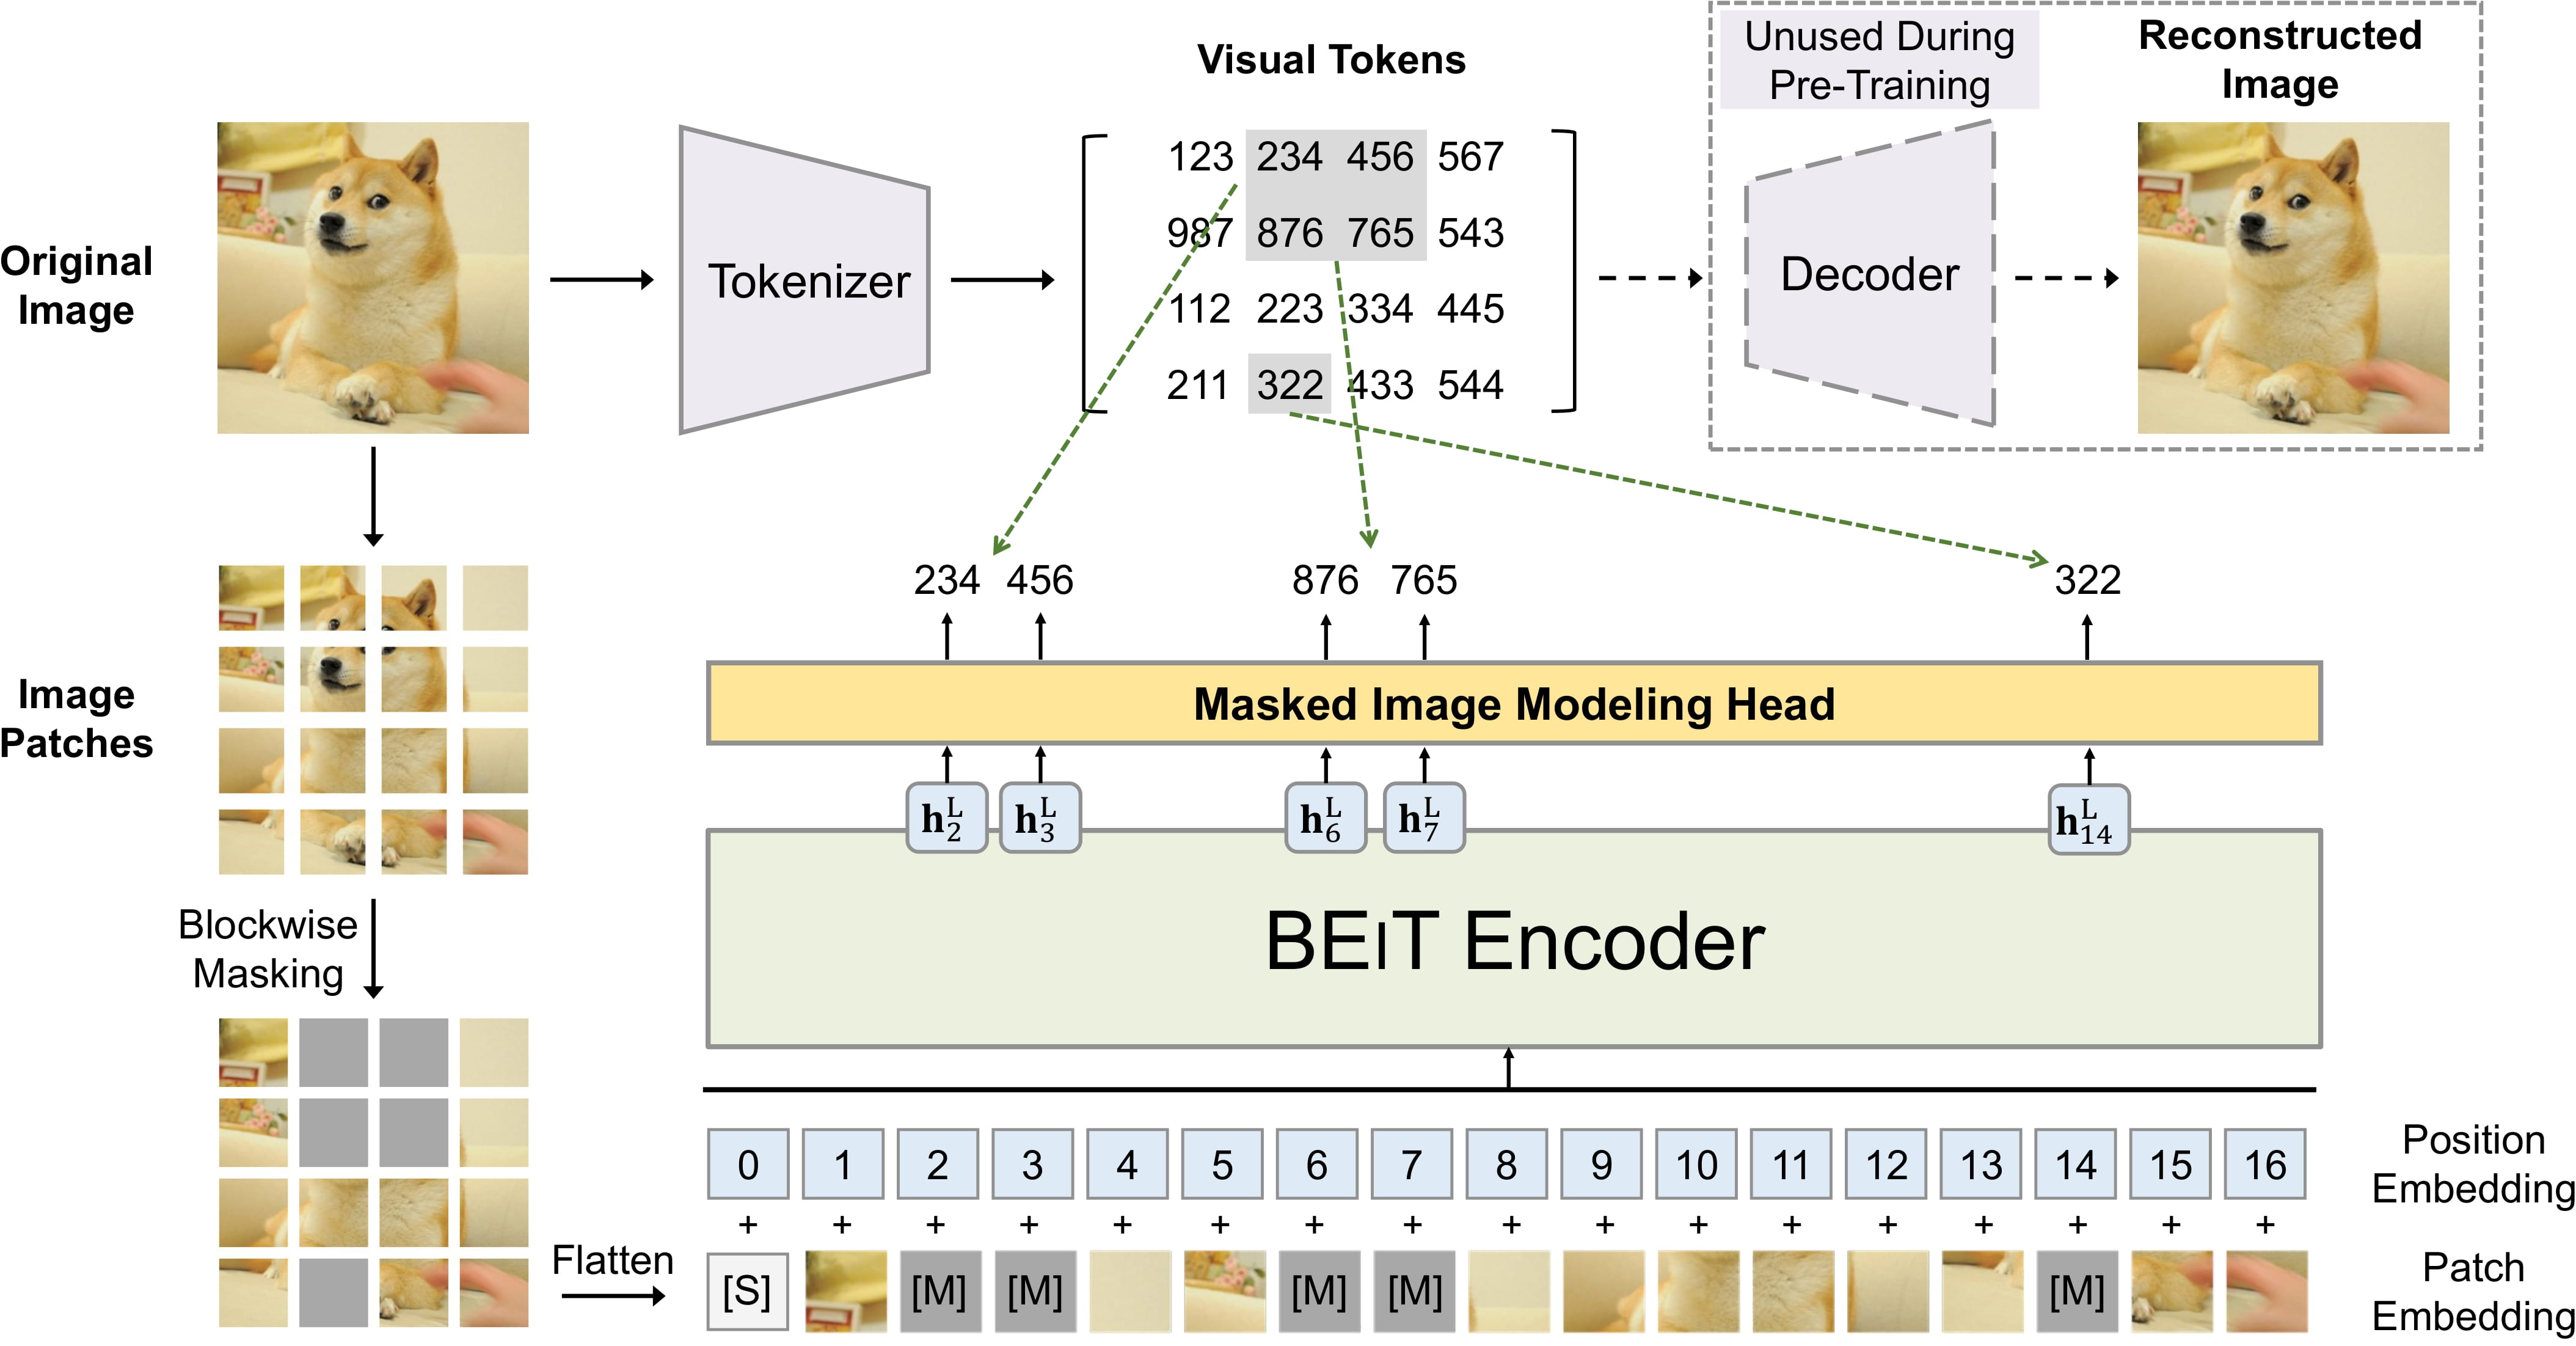 Pré-entraînement de BEiT. Tiré de l'article original.
### Utilisation de l'attention à produit scalaire mis à l'échelle (SDPA)
PyTorch intègre un opérateur natif d'attention par produit scalaire mis à l'échelle (SDPA) au sein de `torch.nn.functional`. Cette fonction englobe plusieurs implémentations qui peuvent être appliquées en fonction des entrées et du matériel utilisé. Consultez la [documentation officielle](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) ou la page [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention) pour plus d'informations.
SDPA est utilisé par défaut pour `torch>=2.1.1` lorsqu’une implémentation est disponible, mais vous pouvez également définir `attn_implementation="sdpa"` dans `from_pretrained()` pour demander explicitement l’utilisation de SDPA.
```python
from transformers import BeitForImageClassification
model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224", attn_implementation="sdpa", device_map="auto")
...
```
Pour obtenir les accélérations optimales, nous recommandons de charger le modèle en demi-précision (par exemple `torch.float16` ou `torch.bfloat16`).
Sur un benchmark local (NVIDIA GeForce RTX 2060-8GB, PyTorch 2.5.1, OS Ubuntu 20.04) avec `float16` et le modèle `microsoft/beit-base-patch16-224`, nous avons observé les améliorations suivantes lors de l’entraînement et de l’inférence :
#### Entraînement
| num_training_steps | batch_size | image_size | is_cuda | Temps par lot (eager - s) | Temps par lot (sdpa - s) | Accélération (%) | Mémoire pic Eager (Mo) | Mémoire pic SDPA (Mo) | Économie de mémoire (%) |
|--------------------|------------|--------------|---------|----------------------------|---------------------------|-------------|----------------------|--------------------|----------------|
| 50 | 2 | (1048, 640) | True | 0.984 | 0.746 | 31.975 | 6738.915 | 4319.886 | 55.998 |
#### Inférence
| Taille du lot d'images | Eager (s/itération) | CI Eager, % | Mémoire en mode Eager (Mo) | SDPA (s/itér.) | SDPA CI, % | Mémoire SDPA (Mo) | Accélération de SDPA | Mémoire économisée par SDPA (%) |
|-------------------:|-----------------:|:--------------|--------------------:|----------------:|:-------------|-------------------:|---------------:|----------------------:|
| 1 | 0.012 | ±0.3% | 3.76657e+08 | 0.011 | ±0.5% | 3.75739e+08 | 1.05 | 0.244 |
| 4 | 0.013 | ±0.1% | 4.03147e+08 | 0.011 | ±0.2% | 3.90554e+08 | 1.178 | 3.225 |
| 16 | 0.045 | ±0.1% | 4.96697e+08 | 0.035 | ±0.1% | 4.51232e+08 | 1.304 | 10.076 |
| 32 | 0.088 | ±0.1% | 6.24417e+08 | 0.066 | ±0.1% | 5.33488e+08 | 1.325 | 17.044 |
## Ressources
Une liste de ressources officielles Hugging Face et de la communauté (indiquées par 🌎) pour vous aider à démarrer avec BEiT.
- [BeitForImageClassification](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitForImageClassification) est pris en charge par ce [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb).
- Voir aussi : [Guide de la tâche de classification d'images](../tasks/image_classification)
**Segmentation sémantique**
- [Guide de la tâche de segmentation sémantique](../tasks/semantic_segmentation)
Si vous souhaitez soumettre une ressource pour qu'elle soit incluse ici, n'hésitez pas à ouvrir une Pull Request et nous la examinerons ! La ressource devrait idéalement démontrer quelque chose de nouveau plutôt que de dupliquer une ressource existante.
## Sorties spécifiques à BEiT[[transformers.models.beit.modeling_beit.BeitModelOutputWithPooling]]
#### transformers.models.beit.modeling_beit.BeitModelOutputWithPooling[[transformers.models.beit.modeling_beit.BeitModelOutputWithPooling]]
```python
transformers.models.beit.modeling_beit.BeitModelOutputWithPooling(last_hidden_state: typing.Optional[torch.Tensor] = None, pooler_output: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor, ...] | None = None, attentions: tuple[torch.Tensor, ...] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L54)
**Paramètres :**
last_hidden_state (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) : Séquence d'états cachés à la sortie de la dernière couche du modèle.
pooler_output (`torch.Tensor` de forme `(batch_size, hidden_size)`) : Moyenne des états cachés de la dernière couche des jetons de patch (en excluant le jeton *[CLS]*) si *config.use_mean_pooling* est défini sur True. S'il est défini sur False, l'état caché final du jeton *[CLS]* est renvoyé.
hidden_states (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) : Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`. États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d’embedding initiales facultatives.
attentions (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) : Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`. Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Classe pour les sorties de [BeitModel](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitModel).
## BeitConfig[[transformers.BeitConfig]]
#### transformers.BeitConfig[[transformers.BeitConfig]]
```python
transformers.BeitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 8192, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, use_mask_token: bool = False, use_absolute_position_embeddings: bool = False, use_relative_position_bias: bool = False, use_shared_relative_position_bias: bool = False, layer_scale_init_value: float = 0.1, drop_path_rate: float | int = 0.1, use_mean_pooling: bool = True, pool_scales: list[int] | tuple[int, ...] = (1, 2, 3, 6), use_auxiliary_head: bool = True, auxiliary_loss_weight: float = 0.4, auxiliary_channels: int = 256, auxiliary_num_convs: int = 1, auxiliary_concat_input: bool = False, semantic_loss_ignore_index: int = 255, _out_features: list[str] | None = None, _out_indices: list[int] | None = None, add_fpn: bool = False, reshape_hidden_states: bool = True)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/configuration_beit.py#L25)
**Paramètres :**
vocab_size (`int`, *facultatif*, valeur par défaut `8192`) : Taille du vocabulaire du modèle. Définit le nombre de jetons différents qui peuvent être représentés par `input_ids`.
hidden_size (`int`, *facultatif*, par défaut `768`) : Dimension des représentations cachées.
num_hidden_layers (`int`, *facultatif*, par défaut `12`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `12`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
intermediate_size (`int`, *facultatif*, par défaut `3072`) : Dimension des représentations MLP.
hidden_act (`str`, *facultatif*, par défaut `gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : La probabilité de dropout pour toutes les couches entièrement connectées des embeddings, de l'encodeur et du pooler.
attention_probs_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
layer_norm_eps (`float`, *facultatif*, par défaut `1e-12`) : L'épsilon utilisé par les couches de normalisation par couche.
image_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `224`) : La taille (résolution) de chaque image.
patch_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `16`) : La taille (résolution) de chaque patch.
num_channels (`int`, *facultatif*, par défaut `3`) : Le nombre de canaux d'entrée.
use_mask_token (`bool`, *facultatif*, par défaut `False`) : Indique s'il faut utiliser un jeton de masque pour le modélisation d'image masquée.
use_absolute_position_embeddings (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut utiliser des embeddings de position absolue.
use_relative_position_bias (`bool`, *facultatif*, par défaut `False`) : Indique s'il faut utiliser des embeddings de position relative de type T5 dans les couches d'auto-attention.
use_shared_relative_position_bias (`bool`, *facultatif*, par défaut `False`) : Indique s'il faut utiliser les mêmes embeddings de position relative dans toutes les couches d'auto-attention du Transformer.
layer_scale_init_value (`float`, *facultatif*, valeur par défaut `0.1`) : Échelle à utiliser dans les couches d'auto-attention. 0.1 pour les modèles de base, 1e-6 pour les grands modèles. Définir 0 pour désactiver l'échelle de couche.
drop_path_rate (`Union[float, int]`, *facultatif*, valeur par défaut `0.1`) : Taux de drop path pour la fusion des patches.
use_mean_pooling (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut effectuer un pooling moyen sur les états cachés finaux des patches plutôt que d'utiliser l'état caché final du jeton CLS, avant d'appliquer la tête de classification.
pool_scales (`tuple[int]`, *facultatif*, valeur par défaut `[1, 2, 3, 6]`) : Échelles de pooling utilisées dans le Pooling Pyramid Module appliquées à la dernière carte de caractéristiques.
use_auxiliary_head (`bool`, *facultatif*, par défaut `True`) : Indique s'il faut utiliser une tête auxiliaire pendant l'entraînement.
auxiliary_loss_weight (`float`, *facultatif*, valeur par défaut 0,4) : Poids de la perte d'entropie croisée de la tête auxiliaire.
auxiliary_channels (`int`, *facultatif*, valeur par défaut : 256) : Nombre de canaux à utiliser dans la tête auxiliaire.
auxiliary_num_convs (`int`, *facultatif*, par défaut 1) : Nombre de couches convolutives à utiliser dans la tête auxiliaire.
auxiliary_concat_input (`bool`, *facultatif*, par défaut `False`) : Indique s'il faut concaténer la sortie de la tête auxiliaire avec l'entrée avant la couche de classification.
semantic_loss_ignore_index (`int`, *facultatif*, valeur par défaut `255`) : L'index ignoré par la fonction de perte du modèle de segmentation sémantique.
add_fpn (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut ajouter un FPN au backbone. Ne concerne que `BeitBackbone`.
reshape_hidden_states (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner les cartes de caractéristiques en tenseurs 4D de forme `(batch_size, hidden_size, height, width)` lorsque le modèle est utilisé comme backbone. Si `False`, les cartes de caractéristiques seront des tenseurs 3D de forme `(batch_size, seq_len, hidden_size)`. Ne concerne que `BeitBackbone`.
Ceci est la classe de configuration destinée à stocker la configuration d'un BeitModel. Elle est utilisée pour instancier un modèle Beit selon les arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [microsoft/beit-base-patch16-224-pt22k](https://huggingface.co/microsoft/beit-base-patch16-224-pt22k)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import BeitConfig, BeitModel
>>> # Initializing a BEiT beit-base-patch16-224-pt22k style configuration
>>> configuration = BeitConfig()
>>> # Initializing a model (with random weights) from the beit-base-patch16-224-pt22k style configuration
>>> model = BeitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## BeitImageProcessor[[transformers.BeitImageProcessor]]
#### transformers.BeitImageProcessor[[transformers.BeitImageProcessor]]
```python
transformers.BeitImageProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_beit.py#L50)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 224, 'width': 224}`) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 224, 'width': 224}`) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `3`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir de l'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.5, 0.5, 0.5]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.5, 0.5, 0.5]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
do_reduce_labels (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_reduce_labels`) : Indique s'il faut réduire de 1 toutes les valeurs d'étiquettes des cartes de segmentation. Utilisé généralement pour les jeux de données où 0 est utilisé pour l'arrière-plan, et où l'arrière-plan lui-même n'est pas inclus dans toutes les classes d'un jeu de données (par ex. ADE20k). L'étiquette d'arrière-plan sera remplacée par 255.
Construit un processeur d’images BeitImageProcessor.
#### prétraiter[[transformers.BeitImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_beit.py#L70)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
segmentation_maps (`ImageInput`, *facultatif*) : Les cartes de segmentation à prétraiter.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
do_reduce_labels (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_reduce_labels`) : Indique s'il faut réduire de 1 toutes les valeurs d'étiquettes des cartes de segmentation. Utilisé généralement pour les jeux de données où 0 est utilisé pour l'arrière-plan, et où l'arrière-plan lui-même n'est pas inclus dans toutes les classes d'un jeu de données (par ex. ADE20k). L'étiquette d'arrière-plan sera remplacée par 255.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
#### post_process_semantic_segmentation[[transformers.BeitImageProcessor.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple] | None = None, return_segmentation_scores: bool = False)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_beit.py#L183)
**Paramètres :**
outputs ([BeitForSemanticSegmentation](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitForSemanticSegmentation)) : Sorties brutes du modèle.
target_sizes (`list[Tuple]` de longueur `batch_size`, *facultatif*) : Liste de tuples correspondant à la taille finale demandée (hauteur, largeur) de chaque prédiction. Si non défini, les prédictions ne seront pas redimensionnées.
return_segmentation_scores (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut retourner les scores de segmentation en plus de la carte de segmentation. Si `True`, chaque élément de la liste retournée est un `SemanticSegmentationPostProcessorOutput` avec les champs `segmentation` (identifiants de classes, forme `(height, width)`) et `segmentation_scores` (forme `(num_classes, height, width)`).
**Retourne :** `list[torch.Tensor]` ou `list[SemanticSegmentationPostProcessorOutput]`
Lorsque `return_segmentation_scores=False` (par défaut), une liste de longueur `batch_size` où chaque élément est une carte de segmentation de forme `(height, width)` avec des identifiants de classes. Lorsque `return_segmentation_scores=True`, une liste de `SemanticSegmentationPostProcessorOutput` avec les champs `segmentation` (identifiants de classes, forme `(height, width)`) et `segmentation_scores` (forme `(num_classes, height, width)`). Dans les deux cas, `(height, width)` correspond à la taille cible (si `target_sizes` est spécifiée).
Convertit la sortie de [BeitForSemanticSegmentation](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitForSemanticSegmentation) en cartes de segmentation sémantique.
## BeitImageProcessorPil[[transformers.BeitImageProcessorPil]]
#### transformers.BeitImageProcessorPil[[transformers.BeitImageProcessorPil]]
```python
transformers.BeitImageProcessorPil(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_pil_beit.py#L53)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 224, 'width': 224}`) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 224, 'width': 224}`) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `3`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir de l'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.5, 0.5, 0.5]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.5, 0.5, 0.5]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
do_reduce_labels (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_reduce_labels`) : Indique s'il faut réduire de 1 toutes les valeurs d'étiquettes des cartes de segmentation. Utilisé généralement pour les jeux de données où 0 est utilisé pour l'arrière-plan, et où l'arrière-plan lui-même n'est pas inclus dans toutes les classes d'un jeu de données (par ex. ADE20k). L'étiquette d'arrière-plan sera remplacée par 255.
Construit un processeur d’images BeitImageProcessor.
#### prétraiter[[transformers.BeitImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_pil_beit.py#L73)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
segmentation_maps (`ImageInput`, *facultatif*) : Les cartes de segmentation à prétraiter.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
do_reduce_labels (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_reduce_labels`) : Indique s'il faut réduire de 1 toutes les valeurs d'étiquettes des cartes de segmentation. Utilisé généralement pour les jeux de données où 0 est utilisé pour l'arrière-plan, et où l'arrière-plan lui-même n'est pas inclus dans toutes les classes d'un jeu de données (par ex. ADE20k). L'étiquette d'arrière-plan sera remplacée par 255.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
#### post_process_semantic_segmentation[[transformers.BeitImageProcessorPil.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple] | None = None, return_segmentation_scores: bool = False)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_pil_beit.py#L169)
**Paramètres :**
outputs ([BeitForSemanticSegmentation](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitForSemanticSegmentation)) : Sorties brutes du modèle.
target_sizes (`list[Tuple]` de longueur `batch_size`, *facultatif*) : Liste de tuples correspondant à la taille finale demandée (hauteur, largeur) de chaque prédiction. Si non défini, les prédictions ne seront pas redimensionnées.
return_segmentation_scores (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut retourner les scores de segmentation en plus de la carte de segmentation. Si `True`, chaque élément de la liste retournée est un `SemanticSegmentationPostProcessorOutput` avec les champs `segmentation` (identifiants de classes, forme `(height, width)`) et `segmentation_scores` (forme `(num_classes, height, width)`).
**Retourne :** `list[torch.Tensor]` ou `list[SemanticSegmentationPostProcessorOutput]`
Lorsque `return_segmentation_scores=False` (par défaut), une liste de longueur `batch_size` où chaque élément est une carte de segmentation de forme `(height, width)` avec des identifiants de classes. Lorsque `return_segmentation_scores=True`, une liste de `SemanticSegmentationPostProcessorOutput` avec les champs `segmentation` (identifiants de classes, forme `(height, width)`) et `segmentation_scores` (forme `(num_classes, height, width)`). Dans les deux cas, `(height, width)` correspond à la taille cible (si `target_sizes` est spécifiée).
Convertit la sortie de [BeitForSemanticSegmentation](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitForSemanticSegmentation) en cartes de segmentation sémantique.
## BeitModel[[transformers.BeitModel]]
#### transformers.BeitModel[[transformers.BeitModel]]
```python
transformers.BeitModel(config: BeitConfig, add_pooling_layer: bool = True)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L486)
**Paramètres :**
config ([BeitConfig](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
add_pooling_layer (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter une couche de pooling
Le modèle Beit brut, qui produit des états cachés bruts sans aucune tête spécifique au sommet.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.BeitModel.forward]]
```python
forward(pixel_values: Tensor, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, interpolate_pos_encoding: bool = False, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L512)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [BeitImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitImageProcessor). Voir [BeitImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [BeitImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitImageProcessor) pour le traitement des images).
bool_masked_pos (`torch.BoolTensor` de forme `(batch_size, num_patches)`, *facultatif*) : Positions masquées booléennes. Indique quels patches sont masqués (1) et lesquels ne le sont pas (0).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
**Retourne :** [BeitModelOutputWithPooling](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.models.beit.modeling_beit.BeitModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BeitModelOutputWithPooling](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.models.beit.modeling_beit.BeitModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([BeitConfig](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitConfig)) et les entrées.
La méthode forward du modèle [BeitModel](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- Moyenne des états cachés de la dernière couche des jetons de patch (en excluant le jeton *[CLS]*) si *config.use_mean_pooling* est défini sur True. S'il est défini sur False, l'état caché final du jeton *[CLS]* est renvoyé.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemple :
```python
```
## BeitForMaskedImageModeling[[transformers.BeitForMaskedImageModeling]]
#### transformers.BeitForMaskedImageModeling[[transformers.BeitForMaskedImageModeling]]
```python
transformers.BeitForMaskedImageModeling(config: BeitConfig)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L583)
**Paramètres :**
config ([BeitConfig](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Transformeur de modèle Beit doté d'une tête de modélisation « language » en tête. BEiT effectue la modélisation d'images masquées en prédisant les jetons visuels d'un auto-encodeur variationnel vectoriellement quantifié (VQ-VAE), tandis que d'autres modèles de vision comme ViT et DeiT prédisent les valeurs de pixels RGB. En conséquence, cette classe est incompatible avec [AutoModelForMaskedImageModeling](/docs/transformers/v5.23.0/fr/model_doc/auto#transformers.AutoModelForMaskedImageModeling), il faudra donc utiliser directement [BeitForMaskedImageModeling](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitForMaskedImageModeling) si vous souhaitez effectuer de la modélisation d'images masquées avec BEiT.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.BeitForMaskedImageModeling.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L600)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [BeitImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitImageProcessor). Voir [BeitImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [BeitImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitImageProcessor) pour le traitement des images).
bool_masked_pos (`torch.BoolTensor` de forme `(batch_size, num_patches)`) : Positions masquées booléennes. Indique quels patches sont masqués (1) et lesquels ne le sont pas (0).
labels (`torch.LongTensor` de forme `(batch_size,)`, *facultatif*) : Étiquettes pour le calcul de la perte de classification/régression d'image. Les indices doivent être dans `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1`, une perte de régression est calculée (perte du carré moyen). Si `config.num_labels > 1`, une perte de classification est calculée (entropie croisée).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
**Retourne :** [MaskedLMOutput](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) ou `tuple(torch.Tensor)`
Un [MaskedLMOutput](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments en fonction de la configuration ([BeitConfig](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitConfig)) et des entrées.
La méthode forward de [BeitForMaskedImageModeling](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitForMaskedImageModeling) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de modélisation de langage masquée (MLM).
- **logits** (`torch.Tensor` de forme `(batch_size, sequence_length, config.vocab_size)`) -- Scores de prédiction de la tête de modélisation du langage (scores pour chaque jeton du vocabulaire avant SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from transformers import AutoImageProcessor, BeitForMaskedImageModeling
>>> import torch
>>> from PIL import Image
>>> import requests
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForMaskedImageModeling.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> num_patches = (model.config.image_size // model.config.patch_size) ** 2
>>> pixel_values = image_processor(images=image, return_tensors="pt").pixel_values
>>> # create random boolean mask of shape (batch_size, num_patches)
>>> bool_masked_pos = torch.randint(low=0, high=2, size=(1, num_patches)).bool()
>>> outputs = model(pixel_values, bool_masked_pos=bool_masked_pos)
>>> loss, logits = outputs.loss, outputs.logits
>>> list(logits.shape)
[1, 196, 8192]
```
## BeitForImageClassification[[transformers.BeitForImageClassification]]
#### transformers.BeitForImageClassification[[transformers.BeitForImageClassification]]
```python
transformers.BeitForImageClassification(config: BeitConfig)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L675)
**Paramètres :**
config ([BeitConfig](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Transformeur de modèle Beit doté d'une tête de classification d'images au sommet (une couche linéaire au-dessus de la moyenne des états cachés finaux des jetons de patch), par exemple pour ImageNet.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.BeitForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L688)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [BeitImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitImageProcessor). Voir [BeitImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [BeitImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitImageProcessor) pour le traitement des images).
labels (`torch.LongTensor` de forme `(batch_size,)`, *facultatif*) : Étiquettes pour le calcul de la perte de classification/régression d'image. Les indices doivent être dans `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1`, une perte de régression est calculée (perte du carré moyen). Si `config.num_labels > 1`, une perte de classification est calculée (entropie croisée).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** [ImageClassifierOutput](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) ou `tuple(torch.Tensor)`
Un [ImageClassifierOutput](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([BeitConfig](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitConfig)) et les entrées.
La méthode forward de [BeitForImageClassification](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitForImageClassification) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de classification (ou de régression si config.num_labels==1).
- **logits** (`torch.Tensor` de forme `(batch_size, config.num_labels)`) -- Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque étape) de forme `(batch_size, sequence_length, hidden_size)`. États cachés (également appelés cartes de caractéristiques) du modèle à la sortie de chaque étape.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, patch_size, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemple :
```python
>>> from transformers import AutoImageProcessor, BeitForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```
## BeitForSemanticSegmentation[[transformers.BeitForSemanticSegmentation]]
#### transformers.BeitForSemanticSegmentation[[transformers.BeitForSemanticSegmentation]]
```python
transformers.BeitForSemanticSegmentation(config: BeitConfig)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L978)
**Paramètres :**
config ([BeitConfig](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle Beit avec une tête de segmentation sémantique au sommet, par exemple pour ADE20K, CityScapes.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.BeitForSemanticSegmentation.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L1000)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [BeitImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitImageProcessor). Voir [BeitImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [BeitImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitImageProcessor) pour le traitement des images).
labels (`torch.LongTensor` de forme `(batch_size, height, width)`, *facultatif*) : Cartes de segmentation sémantique de référence pour le calcul de la perte. Les indices doivent être dans `[0, ..., config.num_labels - 1]`. Si `config.num_labels > 1`, une perte de classification est calculée (entropie croisée).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** [SemanticSegmenterOutput](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.SemanticSegmenterOutput) ou `tuple(torch.Tensor)`
Un [SemanticSegmenterOutput](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.SemanticSegmenterOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([BeitConfig](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitConfig)) et les entrées.
La méthode forward de [BeitForSemanticSegmentation](/docs/transformers/v5.23.0/fr/model_doc/beit#transformers.BeitForSemanticSegmentation) surcharge la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de classification (ou de régression si config.num_labels==1).
- **logits** (`torch.Tensor` de forme `(batch_size, config.num_labels, logits_height, logits_width)`) -- Scores de classification pour chaque pixel.
Les logits retournés n'ont pas nécessairement la même taille que les `pixel_values` passés en entrée. Cela permet d'éviter de réaliser deux interpolations et de perdre en qualité lorsqu'un utilisateur doit redimensionner les logits à la taille de l'image d'origine en post-traitement. Vous devez toujours vérifier la forme de vos logits et les redimensionner au besoin.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, patch_size, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, patch_size, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from transformers import AutoImageProcessor, BeitForSemanticSegmentation
>>> from PIL import Image
>>> import requests
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> model = BeitForSemanticSegmentation.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # logits are of shape (batch_size, num_labels, height, width)
>>> logits = outputs.logits
```