# Audio Spectrogram Transformer
## 概要
Audio Spectrogram Transformer モデルは、Yuan Gong、Yu-An Chung、James Glass による [AST: Audio Spectrogram Transformer](https://huggingface.co/papers/2104.01778) で提案されました。Audio Spectrogram Transformer は、オーディオを画像(スペクトログラム)に変換することで、[Vision Transformer](vit) をオーディオに適用します。このモデルは、オーディオ分類において最先端の結果を達成しています。
論文の抄録は以下の通りです。
*過去10年間で、畳み込みニューラルネットワーク(CNN)は、音声スペクトログラムから対応するラベルへの直接的なマッピングを学習することを目的とするエンドツーエンドの音声分類モデルの主要な構成要素として広く採用されてきました。長距離のグローバルなコンテキストをよりよく捉えるために、CNNの上に自己注意機構を追加してCNN-アテンションハイブリッドモデルを構成するという最近のトレンドがあります。しかし、CNNへの依存が本当に必要なのか、また純粋にアテンションに基づくニューラルネットワークだけで音声分類において良好な性能を得られるのかは不明です。本論文では、音声分類のための最初の畳み込みなしで純粋にアテンションに基づくモデルであるAudio Spectrogram Transformer(AST)を導入することで、この問いに答えます。ASTを様々な音声分類ベンチマークで評価したところ、AudioSetで0.485 mAP、ESC-50で95.6%の精度、Speech Commands V2で98.1%の精度という新たな最良の結果(state-of-the-art)を達成しました。*
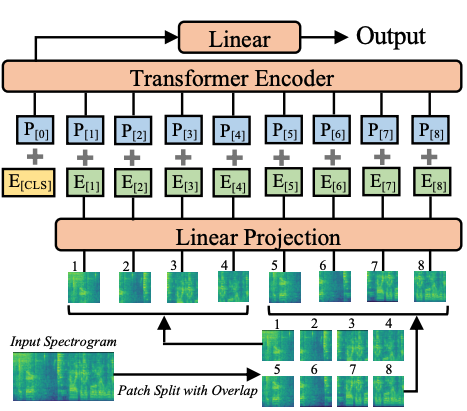 Audio Spectrogram Transformerアーキテクチャ。元の論文より引用。
このモデルは [nielsr](https://huggingface.co/nielsr) によって提供されました。元のコードは [こちら](https://github.com/YuanGongND/ast) で確認できます。
## 使用のコツ
- 独自のデータセットでAudio Spectrogram Transformer (AST)をファインチューニングする際は、入力正規化(
入力の平均が 0、標準偏差が 0.5 であることを確認してください)。[ASTFeatureExtractor](/docs/transformers/main/ja/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor) がこれに対応します。デフォルトでは AudioSet の平均と標準偏差を使用している点にご注意ください。下流データセットの統計量を著者がどのように計算しているかは、[`ast/src/get_norm_stats.py`](https://github.com/YuanGongND/ast/blob/master/src/get_norm_stats.py) を確認してください。
- ASTには低い学習率が必要です(著者は、…
[PSLA論文](https://huggingface.co/papers/2102.01243))で、収束が速いため、タスクに適した学習率と学習率スケジューラを検索してください。
### Scaled Dot Product Attention (SDPA) の使用
PyTorchには、`torch.nn.functional`の一部として、ネイティブなスケーリングドットプロダクトアテンション(SDPA)オペレーターが含まれています。この関数は、入力や使用しているハードウェアに応じて適用できる複数の実装を備えています。詳細については、[公式ドキュメント](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html)または[GPU推論](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention)ページを参照してください。
`torch>=2.1.1` の場合、実装が利用可能な場合はデフォルトで SDPA が使用されますが、`from_pretrained()` で `attn_implementation="sdpa"` を設定することで、SDPA の使用を明示的に指定することもできます。
```python
from transformers import ASTForAudioClassification
model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593", attn_implementation="sdpa", device_map="auto")
...
```
最大限の高速化を実現するには、モデルを半精度(例: `torch.float16` または `torch.bfloat16`)で読み込むことをお勧めします。
ローカル環境でのベンチマーク(A100-40GB、PyTorch 2.3.0、OS Ubuntu 22.04)において、`float32` と `MIT/ast-finetuned-audioset-10-10-0.4593` モデルを使用した場合、推論時に以下の速度向上を確認しました。
| バッチサイズ | 平均推論時間 (ms)、eager モード | 平均推論時間 (ms)、sdpa モデル | Speed up, Sdpa / Eager (x) |
|--------------|-------------------------------------------|-------------------------------------------|------------------------------|
| 1 | 27 | 6 | 4.5 |
| 2 | 12 | 6 | 2 |
| 4 | 21 | 8 | 2.62 |
| 8 | 40 | 14 | 2.86 |
## リソース
Audio Spectrogram Transformer の入門を支援するための、Hugging Face 公式およびコミュニティ(🌎 で示す)のリソースのリストです。
- 音声分類におけるASTを用いた推論を示すノートブックは、[こちら](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/AST)で確認できます。
- [ASTForAudioClassification](/docs/transformers/main/ja/model_doc/audio-spectrogram-transformer#transformers.ASTForAudioClassification) は、この [ノートブック](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/audio_classification.ipynb) でサポートされています。
- 関連項目: [音声分類](../tasks/audio_classification)。
ここにリソースを掲載していただくことを希望される場合は、Pull Request を開いてください。レビューいたします。リソースは、既存のリソースと重複するのではなく、新しいものを示すことが望ましいです。
## ASTConfig[[transformers.ASTConfig]]
#### transformers.ASTConfig[[transformers.ASTConfig]]
```python
transformers.ASTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, patch_size: int | list[int] | tuple[int, int] = 16, qkv_bias: bool = True, frequency_stride: int = 10, time_stride: int = 10, max_length: int = 1024, num_mel_bins: int = 128)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/configuration_audio_spectrogram_transformer.py#L24)
**パラメータ:**
hidden_size (`int`、*任意*、デフォルトは`768`) : 隠れ表現の次元数。
num_hidden_layers (`int`, *任意*, デフォルトは `12`) : Transformer デコーダーの隠れ層の数。
num_attention_heads (`int`、*任意*、デフォルトは `12`) : Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。
intermediate_size (`int`、*任意*、デフォルトは `3072`) : MLP 表現の次元数。
hidden_act (`str`、*任意*、デフォルトは`gelu`) : デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、`"gelu"`、`"relu"`、`"silu"`など。
hidden_dropout_prob (`Union[float, int]`、*任意*、デフォルトは`0.0`) : embeddings、encoder、pooler 内のすべての全結合層における dropout 確率。
attention_probs_dropout_prob (`Union[float, int]`、*任意*、デフォルトは`0.0`) : 注意確率のドロップアウト率。
initializer_range (`float`、*任意*、デフォルトは`0.02`) : すべての重み行列を初期化するためのtruncated_normal_initializerの標準偏差です。
layer_norm_eps (`float`、*任意*、デフォルトは `1e-12`) : layer normalization レイヤーで使用する epsilon。
patch_size (`Union[int, list[int], tuple[int, int]]`、*任意*、デフォルトは`16`) : 各パッチのサイズ(解像度)。
qkv_bias (`bool`, *任意*, デフォルトは `True`) : クエリ、キー、バリューにバイアスを追加するかどうか。
frequency_stride (`int`、*任意*、デフォルトは 10) : スペクトログラムをパッチ化する際に使用する周波数方向のストライド。
time_stride (`int`、*optional*、デフォルトは 10) : スペクトログラムをパッチ化する際に使用する時間方向のストライド。
max_length (`int`、*optional*、デフォルトは 1024) : スペクトログラムの時間次元。
num_mel_bins (`int`、*任意*、デフォルトは`128`) : 入力フレームごとに使用されるメル特徴の数を指定します。`AutoFeatureExtractor`クラスで使用される値と一致させる必要があります。
これは、Audio Spectrogram Transformerモデルの設定を保存するための設定クラスです。指定された引数に基づいて Audio Spectrogram Transformer モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、[MIT/ast-finetuned-audioset-10-10-0.4593](https://huggingface.co/MIT/ast-finetuned-audioset-10-10-0.4593) と同様の設定が得られます。
設定オブジェクトは [PreTrainedConfig](/docs/transformers/main/ja/main_classes/configuration#transformers.PreTrainedConfig) を継承し、モデルの出力を制御するために使用できます。詳細については、[PreTrainedConfig](/docs/transformers/main/ja/main_classes/configuration#transformers.PreTrainedConfig) のドキュメントを参照してください。
例:
```python
>>> from transformers import ASTConfig, ASTModel
>>> # Initializing a AST MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> configuration = ASTConfig()
>>> # Initializing a model (with random weights) from the MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> model = ASTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ASTFeatureExtractor[[transformers.ASTFeatureExtractor]]
#### transformers.ASTFeatureExtractor[[transformers.ASTFeatureExtractor]]
```python
transformers.ASTFeatureExtractor(feature_size = 1, sampling_rate = 16000, num_mel_bins = 128, max_length = 1024, padding_value = 0.0, do_normalize = True, mean = -4.2677393, std = 4.5689974, return_attention_mask = False, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/feature_extraction_audio_spectrogram_transformer.py#L38)
**パラメータ:**
feature_size (`int`、*任意*、デフォルトは 1) : 抽出された特徴量の次元数。
sampling_rate (`int`、*optional*、デフォルトは 16000) : 音声ファイルをデジタル化するためのサンプリングレート(ヘルツ (Hz) 単位)。
num_mel_bins (`int`、*optional*、デフォルトは 128) : Mel 周波数ビンの数。
max_length (`int`、*optional*、デフォルトは 1024) : 抽出された特徴量をパディングまたは切り詰める際の最大長。
do_normalize (`bool`, *任意*, デフォルトは `True`) : `mean` と `std` を使用して log-Mel 特徴を正規化するか否かを指定します。
mean (`float`、*optional*、デフォルト値は -4.2677393) : log-Mel 特徴量を正規化するために使用される平均値です。デフォルトでは AudioSet の平均値を使用します。
std (`float`、*optional*、デフォルト値は 4.5689974) : log-Mel 特徴量を正規化するために使用する標準偏差の値です。デフォルトでは AudioSet の標準偏差を使用します。
return_attention_mask (`bool`、*任意*、デフォルトは`False`) : [__call__()](/docs/transformers/main/ja/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__)が`attention_mask`を返すかどうか。
Audio Spectrogram Transformer (AST) の特徴抽出器を構築します。
このフィーチャーエクストラクターは、主要なメソッドの大部分を含む [SequenceFeatureExtractor](/docs/transformers/main/ja/main_classes/feature_extractor#transformers.SequenceFeatureExtractor) を継承しています。これらのメソッドに関する詳細については、このスーパークラスを参照してください。
このクラスは、インストールされている場合は TorchAudio を、そうでない場合は numpy を使用して、生音声からメルフィルタバンク特徴量を抽出し、固定長にパディングまたは切り詰め、平均と標準偏差を用いて正規化します。
#### __call__[[transformers.ASTFeatureExtractor.__call__]]
```python
__call__(raw_speech: numpy.ndarray | list[float] | list[numpy.ndarray] | list[list[float]], sampling_rate: int | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/feature_extraction_audio_spectrogram_transformer.py#L160)
**パラメータ:**
raw_speech (`np.ndarray`、`list[float]`、`list[np.ndarray]`、`list[list[float]]`) : パディング対象のシーケンスまたはシーケンスのバッチです。各シーケンスは、NumPy 配列、浮動小数点数のリスト、NumPy 配列のリスト、または浮動小数点数のリストのリストであることができます。ステレオではなくモノラルのオーディオで、つまり 1 タイムステップあたり 1 つの浮動小数点数である必要があります。
sampling_rate (`int`, *任意*) : `raw_speech` 入力がサンプリングされたレートです。サイレントエラーを防ぐため、forward 呼び出し時に `sampling_rate` を渡すことを強く推奨します。
return_tensors (`str` または [TensorType](/docs/transformers/main/ja/internal/file_utils#transformers.TensorType)、*optional*) : 設定されている場合、Python の整数のリストではなくテンソルを返します。指定可能な値は以下の通りです。 - `'pt'`: PyTorch の `torch.Tensor` オブジェクトを返します。 - `'np'`: Numpy の `np.ndarray` オブジェクトを返します。
1つ以上のシーケンスを特徴量化し、モデル用に準備するための主要なメソッド。
## ASTModel[[transformers.ASTModel]]
#### transformers.ASTModel[[transformers.ASTModel]]
```python
transformers.ASTModel(config: ASTConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L257)
**パラメータ:**
config ([ASTConfig](/docs/transformers/main/ja/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
特定のヘッドを上に配置せず、生のhidden-statesを出力する、素のAudio Spectrogram Transformer Modelです。
このモデルは [PreTrainedModel](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.ASTModel.forward]]
```python
forward(input_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L273)
**パラメータ:**
input_values (`torch.Tensor`、shape `(batch_size, max_length, num_mel_bins)`) : 生のオーディオ波形から抽出された Float 値の mel 特徴量。生のオーディオ波形は、`.flac` または `.wav` のオーディオファイルを `list[float]`、`numpy.ndarray`、または `torch.Tensor` 型の配列として読み込むことで取得できます。*例えば*、torchcodec ライブラリ(`pip install torchcodec`)や soundfile ライブラリ(`pip install soundfile`)を通じて行います。`input_features` として配列を準備するには、mel 特徴量の抽出、パディング、および `torch.Tensor` 型への変換を行うために [AutoFeatureExtractor](/docs/transformers/main/ja/model_doc/auto#transformers.AutoFeatureExtractor) を使用してください。[__call__()](/docs/transformers/main/ja/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__) を参照してください。
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
**戻り値:** [BaseModelOutputWithPooling](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) または `tuple(torch.Tensor)`
設定([ASTConfig](/docs/transformers/main/ja/model_doc/audio-spectrogram-transformer#transformers.ASTConfig))と入力に応じて、さまざまな要素で構成される、[BaseModelOutputWithPooling](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) または `torch.Tensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。
[ASTModel](/docs/transformers/main/ja/model_doc/audio-spectrogram-transformer#transformers.ASTModel)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **last_hidden_state** (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`) -- モデルの最終層の出力における隠れ状態のシーケンス。
- **pooler_output** (`torch.Tensor`、形状 `(batch_size, hidden_size)`) -- 補助的な事前学習タスクに使用される層をさらに通して処理された後、シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態です。例えば、BERT系のモデルでは、線形層とtanh活性化関数を経て処理された後の分類トークンを返します。この線形層の重みは、事前学習中の次の文予測(分類)目的から学習されます。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
## ASTForAudioClassification[[transformers.ASTForAudioClassification]]
#### transformers.ASTForAudioClassification[[transformers.ASTForAudioClassification]]
```python
transformers.ASTForAudioClassification(config: ASTConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L327)
**パラメータ:**
config ([ASTConfig](/docs/transformers/main/ja/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
Audio Spectrogram Transformer モデルの上部に音声分類ヘッド(プーリングされた出力の上に線形層を配置したもの)を備えたモデル。AudioSet や Speech Commands v2 のようなデータセット向けに使用できます。
このモデルは [PreTrainedModel](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.ASTForAudioClassification.forward]]
```python
forward(input_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L340)
**パラメータ:**
input_values (`torch.Tensor`、shape `(batch_size, max_length, num_mel_bins)`) : 生のオーディオ波形から抽出された Float 値の mel 特徴量。生のオーディオ波形は、`.flac` または `.wav` のオーディオファイルを `list[float]`、`numpy.ndarray`、または `torch.Tensor` 型の配列として読み込むことで取得できます。*例えば*、torchcodec ライブラリ(`pip install torchcodec`)や soundfile ライブラリ(`pip install soundfile`)を通じて行います。`input_features` として配列を準備するには、mel 特徴量の抽出、パディング、および `torch.Tensor` 型への変換を行うために [AutoFeatureExtractor](/docs/transformers/main/ja/model_doc/auto#transformers.AutoFeatureExtractor) を使用してください。[__call__()](/docs/transformers/main/ja/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__) を参照してください。
labels (`torch.LongTensor`、shape `(batch_size,)`、*任意*) : 音声分類/回帰の損失を計算するためのラベル。インデックスは `[0, ..., config.num_labels - 1]` の範囲である必要があります。`config.num_labels == 1` の場合は回帰損失(Mean-Square loss)が計算され、`config.num_labels > 1` の場合は分類損失(Cross-Entropy)が計算されます。
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
**戻り値:** [SequenceClassifierOutput](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) または `tuple(torch.Tensor)`
設定([ASTConfig](/docs/transformers/main/ja/model_doc/audio-spectrogram-transformer#transformers.ASTConfig))と入力に応じて、さまざまな要素で構成される、[SequenceClassifierOutput](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput)または`torch.Tensor`のタプル(`return_dict=False`が渡された場合、または`config.return_dict=False`の場合)。
[ASTForAudioClassification](/docs/transformers/main/ja/model_doc/audio-spectrogram-transformer#transformers.ASTForAudioClassification)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.Tensor`、shape `(1,)`、*optional*、`labels` が指定された場合に返されます) -- 分類損失(config.num_labels==1 の場合は回帰損失)。
- **logits** (`torch.Tensor`、形状 `(batch_size, config.num_labels)`) -- SoftMax 適用前の分類(または config.num_labels==1 の場合は回帰)スコア。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> from transformers import AutoFeatureExtractor, ASTForAudioClassification
>>> from datasets import load_dataset
>>> import torch
>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate
>>> feature_extractor = AutoFeatureExtractor.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(dataset[0]["audio"]["array"], sampling_rate=sampling_rate, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_ids = torch.argmax(logits, dim=-1).item()
>>> predicted_label = model.config.id2label[predicted_class_ids]
>>> predicted_label
...
>>> # compute loss - target_label is e.g. "down"
>>> target_label = model.config.id2label[0]
>>> inputs["labels"] = torch.tensor([model.config.label2id[target_label]])
>>> loss = model(**inputs).loss
>>> round(loss.item(), 2)
...
```