# BridgeTower
## Aperçu
Le modèle BridgeTower a été proposé dans [BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning](https://huggingface.co/papers/2206.08657) par Xiao Xu, Chenfei Wu, Shachar Rosenman, Vasudev Lal, Wanxiang Che et Nan Duan. L’objectif de ce modèle est de construire un pont entre chaque encodeur unimodal et l’encodeur multimodal afin de permettre une interaction complète et détaillée à chaque couche de l’encodeur multimodal, atteignant ainsi des performances remarquables sur diverses tâches en aval avec des coûts de performance et de calcul supplémentaires quasi négligeables.
Cet article a été accepté à la conférence [AAAI'23](https://aaai.org/Conferences/AAAI-23/).
L'abstract de l'article est le suivant :
*Les modèles Vision-Language (VL) dotés d'une architecture TWO-TOWER ont dominé l'apprentissage de la représentation visuelle-langagière ces dernières années. Les modèles VL actuels utilisent soit des encodeurs unimodaux légers et apprennent à extraire, aligner et fusionner simultanément les deux modalités dans un encodeur intermodal profond, soit ils alimentent les représentations unimodales de la dernière couche issues d'encodeurs unimodaux profonds pré-entraînés dans l'encodeur intermodal supérieur. Les deux approches risquent de restreindre l'apprentissage de la représentation visuelle-langagière et de limiter les performances du modèle. Dans cet article, nous proposons BRIDGETOWER, qui introduit plusieurs couches de pont établissant une connexion entre les couches supérieures des encodeurs unimodaux et chaque couche de l'encodeur intermodal. Cela permet un alignement et une fusion intermodaux efficaces, de bas en haut, entre les représentations visuelles et textuelles de différents niveaux sémantiques des encodeurs unimodaux pré-entraînés, au sein de l'encodeur intermodal. Pré-entraîné sur seulement 4 millions d'images, BRIDGETOWER atteint des performances de pointe sur diverses tâches de vision-langage en aval. En particulier, sur le jeu de données test-std de VQAv2, BRIDGETOWER atteint une précision de 78,73 %, dépassant de 1,09 % le modèle de pointe précédent, METER, avec les mêmes données de pré-entraînement et des paramètres et coûts de calcul supplémentaires quasi négligeables. Notamment, lors d'un élargissement supplémentaire du modèle, BRIDGETOWER atteint une précision de 81,15 %, surpassant des modèles pré-entraînés sur des jeux de données de plusieurs ordres de grandeur supérieurs.*
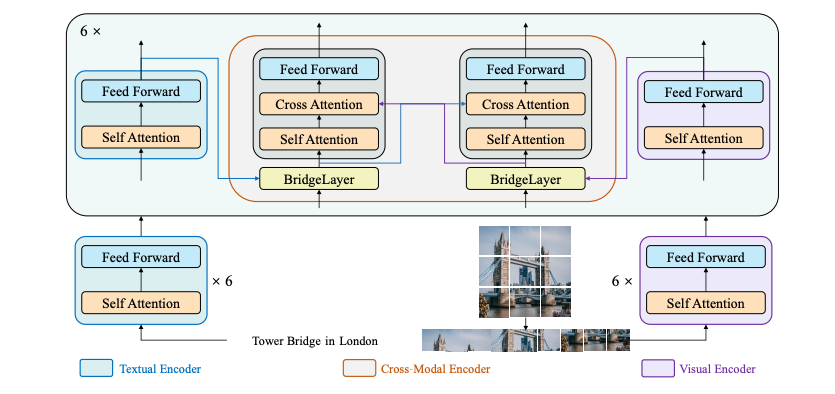 Architecture BridgeTower. Issue de l'article original.
Ce modèle a été contribué par [Anahita Bhiwandiwalla](https://huggingface.co/anahita-b), [Tiep Le](https://huggingface.co/Tile) et [Shaoyen Tseng](https://huggingface.co/shaoyent). Le code d'origine peut être trouvé [ici](https://github.com/microsoft/BridgeTower).
## Conseils et exemples d'utilisation
BridgeTower est composé d'un encodeur visuel, d'un encodeur textuel et d'un encodeur intermodal doté de plusieurs couches de pont légères. L'objectif de cette approche était de créer un pont entre chaque encodeur unimodal et l'encodeur intermodal afin de permettre une interaction complète et détaillée à chaque couche de l'encodeur intermodal. En principe, on peut appliquer n'importe quel encodeur visuel, textuel ou intermodal dans l'architecture proposée.
[BridgeTowerProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerProcessor) encapsule [RobertaTokenizer](/docs/transformers/main/fr/model_doc/led#transformers.RobertaTokenizer) et [BridgeTowerImageProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) en une seule instance afin d’encoder le texte et de préparer les images, respectivement.
L'exemple suivant montre comment exécuter un apprentissage contrastif en utilisant [BridgeTowerProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerProcessor) et [BridgeTowerForContrastiveLearning](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerForContrastiveLearning).
```python
import requests
from PIL import Image
from transformers import BridgeTowerForContrastiveLearning, BridgeTowerProcessor
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc", device_map="auto")
# forward pass
scores = dict()
for text in texts:
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
outputs = model(**encoding)
scores[text] = outputs
```
L'exemple suivant montre comment exécuter la récupération d'images et de texte à l'aide de [BridgeTowerProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerProcessor) et [BridgeTowerForImageAndTextRetrieval](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerForImageAndTextRetrieval).
```python
import requests
from PIL import Image
from transformers import BridgeTowerForImageAndTextRetrieval, BridgeTowerProcessor
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")
# forward pass
scores = dict()
for text in texts:
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
outputs = model(**encoding)
scores[text] = outputs.logits[0, 1].item()
```
L'exemple suivant montre comment exécuter un modèle de langage masqué à l'aide de [BridgeTowerProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerProcessor) et [BridgeTowerForMaskedLM](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerForMaskedLM).
```python
from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
from PIL import Image
import requests
url = "http://images.cocodataset.org/val2017/000000360943.jpg"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
text = "a looking out of the window"
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
# forward pass
outputs = model(**encoding)
results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())
print(results)
.a cat looking out of the window.
```
Astuces :
- Cette implémentation de BridgeTower utilise [RobertaTokenizer](/docs/transformers/main/fr/model_doc/led#transformers.RobertaTokenizer) pour générer des embeddings de texte et le modèle CLIP/ViT d'OpenAI pour calculer les embeddings visuels.
- Les points de contrôle pour le pré-entraînement de [bridgeTower-base](https://huggingface.co/BridgeTower/bridgetower-base) et de [bridgetower masked language modeling and image text matching](https://huggingface.co/BridgeTower/bridgetower-base-itm-mlm) sont publiés.
- Veuillez vous reporter à [Table 5](https://huggingface.co/papers/2206.08657) pour consulter les performances de BridgeTower sur la recherche d'images et d'autres tâches en aval.
## BridgeTowerConfig[[transformers.BridgeTowerConfig]]
#### transformers.BridgeTowerConfig[[transformers.BridgeTowerConfig]]
```python
transformers.BridgeTowerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, share_cross_modal_transformer_layers: bool = True, hidden_act: str = 'gelu', hidden_size: int = 768, initializer_factor: float | int = 1, layer_norm_eps: float = 1e-05, share_link_tower_layers: bool = False, link_tower_type: str = 'add', num_attention_heads: int = 12, num_hidden_layers: int = 6, tie_word_embeddings: bool = False, init_layernorm_from_vision_encoder: bool = False, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/configuration_bridgetower.py#L104)
**Paramètres :**
share_cross_modal_transformer_layers (`bool`, *facultatif*, valeur par défaut `True`) : Indique si les couches du transformeur intermodal sont partagées.
hidden_act (`str`, *facultatif*, par défaut `gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_size (`int`, *facultatif*, par défaut `768`) : Dimension des représentations cachées.
initializer_factor (`Union[float, int]`, *facultatif*, valeur par défaut `1`) : Un facteur pour l'initialisation de toutes les matrices de poids (doit être maintenu à 1, utilisé en interne pour les tests d'initialisation).
layer_norm_eps (`float`, *facultatif*, valeur par défaut `1e-05`) : L'épsilon utilisé par les couches de normalisation de couche.
share_link_tower_layers (`bool`, *facultatif*, valeur par défaut `False`) : Indique si les couches du pont/du tour de liaison sont partagées.
link_tower_type (`str`, *facultatif*, valeur par défaut `"add"`) : Type de la couche de liaison/pont.
num_attention_heads (`int`, *facultatif*, valeur par défaut `12`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
num_hidden_layers (`int`, *facultatif*, valeur par défaut `6`) : Nombre de couches cachées dans le décodeur Transformer.
tie_word_embeddings (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut lier les embeddings de poids selon la correspondance `tied_weights_keys` du modèle.
init_layernorm_from_vision_encoder (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut initialiser LayerNorm à partir de l'encodeur visuel.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone de texte.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone visuel.
Ceci est la classe de configuration destinée à stocker la configuration d'un BridgeTowerModel. Elle est utilisée pour instancier un modèle Bridgetower en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import BridgeTowerModel, BridgeTowerConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration
>>> configuration = BridgeTowerConfig()
>>> # Initializing a model from the BridgeTower/bridgetower-base style configuration
>>> model = BridgeTowerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## BridgeTowerTextConfig[[transformers.BridgeTowerTextConfig]]
#### transformers.BridgeTowerTextConfig[[transformers.BridgeTowerTextConfig]]
```python
transformers.BridgeTowerTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, initializer_factor: float | int = 1, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 514, type_vocab_size: int = 1, layer_norm_eps: float = 1e-05, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, use_cache: bool = True, is_decoder: bool = False, add_cross_attention: bool = False)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/configuration_bridgetower.py#L65)
**Paramètres :**
vocab_size (`int`, *facultatif*, valeur par défaut `50265`) : Taille du vocabulaire du modèle. Définit le nombre de jetons différents qui peuvent être représentés par `input_ids`.
hidden_size (`int`, *facultatif*, par défaut `768`) : Dimension des représentations cachées.
num_hidden_layers (`int`, *facultatif*, par défaut `12`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `12`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
initializer_factor (`Union[float, int]`, *facultatif*, valeur par défaut `1`) : Un facteur pour l'initialisation de toutes les matrices de poids (doit être maintenu à 1, utilisé en interne pour les tests d'initialisation).
intermediate_size (`int`, *facultatif*, par défaut `3072`) : Dimension des représentations MLP.
hidden_act (`str`, *facultatif*, par défaut `gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.1`) : La probabilité de dropout pour toutes les couches entièrement connectées des embeddings, de l'encodeur et du pooler.
attention_probs_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.1`) : Le taux de dropout appliqué aux probabilités d'attention.
max_position_embeddings (`int`, *facultatif*, valeur par défaut `514`) : La longueur de séquence maximale avec laquelle ce modèle pourrait être utilisé.
type_vocab_size (`int`, *facultatif*, par défaut `1`) : La taille du vocabulaire des `token_type_ids`.
layer_norm_eps (`float`, *facultatif*, valeur par défaut `1e-05`) : L'épsilon utilisé par les couches de normalisation de couche.
pad_token_id (`int`, *facultatif*, valeur par défaut `1`) : Identifiant du jeton utilisé pour le bourrage dans le vocabulaire.
bos_token_id (`int`, *facultatif*, valeur par défaut `0`) : Identifiant du jeton utilisé pour le début de flux dans le vocabulaire.
eos_token_id (`Union[int, list[int]]`, *facultatif*, valeur par défaut `2`) : Identifiant de jeton utilisé pour la fin de flux dans le vocabulaire.
use_cache (`bool`, *facultatif*, valeur par défaut `True`) : Indique si le modèle doit retourner les dernières attentions clés/valeurs (non utilisé par tous les modèles). Pertinent uniquement si `config.is_decoder=True` ou si le modèle est un modèle génératif de type décodeur uniquement.
is_decoder (`bool`, *facultatif*, valeur par défaut `False`) : Indique si le modèle est utilisé comme décodeur. Si `False`, le modèle est utilisé comme encodeur.
add_cross_attention (`bool`, *facultatif*, par défaut `False`) : Indique si des couches d'attention croisée doivent être ajoutées au modèle.
Ceci est la classe de configuration destinée à stocker la configuration d'un BridgeTowerModel. Elle est utilisée pour instancier un modèle Bridgetower en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import BridgeTowerTextConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration for the text model
>>> configuration = BridgeTowerTextConfig()
>>> # Accessing the configuration
>>> configuration
```
## BridgeTowerVisionConfig[[transformers.BridgeTowerVisionConfig]]
#### transformers.BridgeTowerVisionConfig[[transformers.BridgeTowerVisionConfig]]
```python
transformers.BridgeTowerVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_channels: int = 3, patch_size: int | list[int] | tuple[int, int] = 16, image_size: int | list[int] | tuple[int, int] = 288, initializer_factor: float | int = 1, layer_norm_eps: float = 1e-05, stop_gradient: bool = False, share_layernorm: bool = True, remove_last_layer: bool = False)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/configuration_bridgetower.py#L27)
**Paramètres :**
hidden_size (`int`, *facultatif*, par défaut `768`) : Dimension des représentations cachées.
num_hidden_layers (`int`, *facultatif*, par défaut `12`) : Nombre de couches cachées dans le décodeur Transformer.
num_channels (`int`, *facultatif*, par défaut `3`) : Le nombre de canaux d'entrée.
patch_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `16`) : La taille (résolution) de chaque patch.
image_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `288`) : La taille (résolution) de chaque image.
initializer_factor (`Union[float, int]`, *facultatif*, valeur par défaut `1`) : Un facteur pour l'initialisation de toutes les matrices de poids (doit être maintenu à 1, utilisé en interne pour les tests d'initialisation).
layer_norm_eps (`float`, *facultatif*, valeur par défaut `1e-05`) : L'épsilon utilisé par les couches de normalisation de couche.
stop_gradient (`bool`, *facultatif*, par défaut `False`) : Indique s'il faut arrêter la propagation du gradient pour l'entraînement.
share_layernorm (`bool`, *facultatif*, par défaut `True`) : Indique si les couches LayerNorm sont partagées.
remove_last_layer (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut supprimer la dernière couche de l'encodeur visuel.
Ceci est la classe de configuration destinée à stocker la configuration d'un BridgeTowerModel. Elle est utilisée pour instancier un modèle Bridgetower en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import BridgeTowerVisionConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration for the vision model
>>> configuration = BridgeTowerVisionConfig()
>>> # Accessing the configuration
>>> configuration
```
## BridgeTowerImageProcessor[[transformers.BridgeTowerImageProcessor]]
#### transformers.BridgeTowerImageProcessor[[transformers.BridgeTowerImageProcessor]]
```python
transformers.BridgeTowerImageProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/image_processing_bridgetower.py#L76)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'shortest_edge' : 288}`) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'shortest_edge' : 288}`) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `3`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir de l'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.48145466, 0.4578275, 0.40821073]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.26862954, 0.26130258, 0.27577711]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
size_divisor (`int`, *kwargs*, par défaut `32`) : La taille par laquelle il faut s'assurer que la hauteur et la largeur sont divisibles.
Construit un processeur d’images BridgeTowerImageProcessor.
#### prétraiter[[transformers.BridgeTowerImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *facultatif*) : Drapeau de développement pour des entrées supplémentaires de type image qui seront également prétraitées. N'utilisez ce paramètre que si le passage des entrées en tant qu'argument nommé ne fonctionne pas. Par exemple, `preprocess(images, masks=masks)` est l'option recommandée, mais cela peut entraîner des problèmes de priorité des arguments pour certains modèles. Dans ces cas, vous pouvez utiliser à la place `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
Prétraitez une image ou un lot d'images.
## BridgeTowerImageProcessorPil[[transformers.BridgeTowerImageProcessorPil]]
#### transformers.BridgeTowerImageProcessorPil[[transformers.BridgeTowerImageProcessorPil]]
```python
transformers.BridgeTowerImageProcessorPil(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/image_processing_pil_bridgetower.py#L70)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'shortest_edge' : 288}`) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'shortest_edge' : 288}`) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `3`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir de l'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.48145466, 0.4578275, 0.40821073]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.26862954, 0.26130258, 0.27577711]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
size_divisor (`int`, *kwargs*, par défaut `32`) : La taille par laquelle il faut s'assurer que la hauteur et la largeur sont divisibles.
Construit un processeur d’images BridgeTowerImageProcessor.
#### prétraiter[[transformers.BridgeTowerImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *facultatif*) : Drapeau de développement pour des entrées supplémentaires de type image qui seront également prétraitées. N'utilisez ce paramètre que si le passage des entrées en tant qu'argument nommé ne fonctionne pas. Par exemple, `preprocess(images, masks=masks)` est l'option recommandée, mais cela peut entraîner des problèmes de priorité des arguments pour certains modèles. Dans ces cas, vous pouvez utiliser à la place `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
Prétraitez une image ou un lot d'images.
## BridgeTowerProcessor[[transformers.BridgeTowerProcessor]]
#### transformers.BridgeTowerProcessor[[transformers.BridgeTowerProcessor]]
```python
transformers.BridgeTowerProcessor(image_processor, tokenizer)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/processing_bridgetower.py#L24)
**Paramètres :**
image_processor (`BridgeTowerImageProcessor`) : le processeur d'images est une entrée obligatoire.
tokenizer (`RobertaTokenizer`) : le tokenizer est une entrée obligatoire.
Construit un BridgeTowerProcessor qui encapsule un processeur d’images et un tokenizer en un seul processeur.
[BridgeTowerProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerProcessor) offre toutes les fonctionnalités de [BridgeTowerImageProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) et de [RobertaTokenizer](/docs/transformers/main/fr/model_doc/led#transformers.RobertaTokenizer). Consultez [~BridgeTowerImageProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) et [~RobertaTokenizer](/docs/transformers/main/fr/model_doc/led#transformers.RobertaTokenizer) pour plus d’informations.
#### __appel__[[transformers.BridgeTowerProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L670)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *facultatif*) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *facultatif*) : La séquence ou le lot de séquences à encoder. Chaque séquence peut être une chaîne de caractères ou une liste de chaînes (chaîne pré-tokenisée). Si vous transmettez une entrée pré-tokenisée, définissez `is_split_into_words=True` pour éviter toute ambiguïté avec les entrées en lot.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *facultatif*) : Vidéo à prétraiter. S'attend à une vidéo unique ou à un lot de vidéos dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des vidéos dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *facultatif*) : L'audio ou le lot d'audios à préparer. Chaque audio peut être un tableau NumPy ou un tenseur PyTorch. Dans le cas d'un tableau NumPy/d'un tenseur PyTorch, chaque audio doit avoir la forme (C, T), où C est le nombre de canaux et T est la longueur en échantillons de l'audio.
return_mm_token_type_ids (`bool`, *kwargs*) : Indique s'il faut retourner les identifiants de type de jeton multimodal indiquant les positions des jetons de substitution multimodaux.
return_text_replacement_offsets (`bool`, *kwargs*) : Indique s'il faut retourner les décalages de caractères pour chaque emplacement multimodal et son remplacement.
return_tensors (`str` ou [TensorType](/docs/transformers/main/fr/internal/file_utils#transformers.TensorType), *facultatif*) : Si défini, renverra des tenseurs d'un framework particulier. Les valeurs acceptables sont : - `'pt'` : Renvoie des objets `torch.Tensor` de PyTorch. - `'np'` : Renvoie des objets `np.ndarray` de NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/fr/main_classes/processors#transformers.ProcessingKwargs), *facultatif*) : Options de traitement supplémentaires pour chaque modalité (texte, images, vidéos, audio). Les paramètres spécifiques au modèle sont répertoriés ci-dessus ; consultez la classe TypedDict pour la liste complète des arguments pris en charge.
## BridgeTowerModel[[transformers.BridgeTowerModel]]
#### transformers.BridgeTowerModel[[transformers.BridgeTowerModel]]
```python
transformers.BridgeTowerModel(config: BridgeTowerConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1083)
**Paramètres :**
config ([BridgeTowerConfig](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle BridgeTower Model nu, qui renvoie un objet BridgeTowerModelOutput sans aucune tête spécifique
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.BridgeTowerModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, image_token_type_idx: int | None = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1156)
**Paramètres :**
input_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices de jetons de segment indiquant les première et deuxième parties des entrées. Les indices sont sélectionnés dans `[0, 1]` : - 0 correspond à un jeton de *phrase A*, - 1 correspond à un jeton de *phrase B*. [Que sont les identifiants de type de jeton ?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de [BridgeTowerImageProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Voir [BridgeTowerImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([BridgeTowerProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerProcessor) utilise [BridgeTowerImageProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) pour le traitement des images).
pixel_mask (`torch.LongTensor` de forme `(batch_size, height, width)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux valeurs de pixels de bourrage. Les valeurs du masque sont comprises dans `[0, 1]` : - 1 pour les pixels réels (c.-à-d. **non masqués**), - 0 pour les pixels de bourrage (c.-à-d. **masqués**). [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `input_ids`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indices `input_ids` en vecteurs associés, par rapport à la matrice de recherche d'intégration interne du modèle.
image_embeds (`torch.Tensor` de forme `(batch_size, num_patches, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `pixel_values`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir `pixel_values` en embeddings de patchs.
image_token_type_idx (`int`, *facultatif*) : - Les identifiants de type de jeton pour les images.
labels (`torch.LongTensor` de forme `(batch_size,)`, *facultatif*) : Les étiquettes ne sont pas actuellement prises en charge.
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** `BridgeTowerModelOutput` ou `tuple(torch.Tensor)`
Un `BridgeTowerModelOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([BridgeTowerConfig](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerConfig)) et les entrées.
La méthode forward du [BridgeTowerModel](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **text_features** (`torch.Tensor` de forme `(batch_size, text_sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie texte de la dernière couche du modèle.
- **image_features** (`torch.Tensor` de forme `(batch_size, image_sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie image de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size x 2)`) -- Concaténation des états cachés de la dernière couche du premier jeton de la séquence de texte et de la séquence d'image (jeton de classification), respectivement, après un traitement supplémentaire par les couches utilisées pour les tâches de pré-entraînement auxiliaires.
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> # prepare image and text
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "hello world"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base")
>>> model = BridgeTowerModel.from_pretrained("BridgeTower/bridgetower-base")
>>> inputs = processor(image, text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> outputs.keys()
odict_keys(['text_features', 'image_features', 'pooler_output'])
```
## BridgeTowerForContrastiveLearning[[transformers.BridgeTowerForContrastiveLearning]]
#### transformers.BridgeTowerForContrastiveLearning[[transformers.BridgeTowerForContrastiveLearning]]
```python
transformers.BridgeTowerForContrastiveLearning(config: BridgeTowerConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1607)
**Paramètres :**
config ([BridgeTowerConfig](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Modèle BridgeTower avec une tête contrastive image-texte au sommet, calculant la perte contrastive image-texte.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.BridgeTowerForContrastiveLearning.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, return_loss: bool | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1621)
**Paramètres :**
input_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices de jetons de segment indiquant les première et deuxième parties des entrées. Les indices sont sélectionnés dans `[0, 1]` : - 0 correspond à un jeton de *phrase A*, - 1 correspond à un jeton de *phrase B*. [Que sont les identifiants de type de jeton ?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de [BridgeTowerImageProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Voir [BridgeTowerImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([BridgeTowerProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerProcessor) utilise [BridgeTowerImageProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) pour le traitement des images).
pixel_mask (`torch.LongTensor` de forme `(batch_size, height, width)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux valeurs de pixels de bourrage. Les valeurs du masque sont comprises dans `[0, 1]` : - 1 pour les pixels réels (c.-à-d. **non masqués**), - 0 pour les pixels de bourrage (c.-à-d. **masqués**). [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `input_ids`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indices `input_ids` en vecteurs associés, par rapport à la matrice de recherche d'intégration interne du modèle.
image_embeds (`torch.Tensor` de forme `(batch_size, num_patches, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `pixel_values`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir `pixel_values` en embeddings de patchs.
return_loss (`bool`, *facultatif*) : Indique s'il faut ou non retourner la perte contrastive.
**Retourne :** `BridgeTowerContrastiveOutput` ou `tuple(torch.Tensor)`
Un `BridgeTowerContrastiveOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([BridgeTowerConfig](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerConfig)) et les entrées.
La méthode forward de [BridgeTowerForContrastiveLearning](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerForContrastiveLearning) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `return_loss` est `True`) -- Perte contrastive image-texte.
- **logits** (`torch.Tensor` de forme `(batch_size, sequence_length, config.vocab_size)`) -- Scores de prédiction de la tête de modélisation du langage (scores pour chaque jeton du vocabulaire avant SoftMax).
- **text_embeds** (`torch.Tensor)`, *facultatif*, renvoyé lorsque le modèle est initialisé avec `with_projection=True`) -- Les embeddings de texte obtenus en appliquant la couche de projection à pooler_output.
- **image_embeds** (`torch.Tensor)`, *facultatif*, renvoyé lorsque le modèle est initialisé avec `with_projection=True`) -- Les embeddings d'image obtenus en appliquant la couche de projection au pooler_output.
- **cross_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The text-image cross-modal embeddings obtained by applying the projection layer to the pooler_output.
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Exemples :
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForContrastiveLearning
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> image_urls = [
... "https://farm4.staticflickr.com/3395/3428278415_81c3e27f15_z.jpg",
... "http://images.cocodataset.org/val2017/000000039769.jpg",
... ]
>>> texts = ["two dogs in a car", "two cats sleeping on a couch"]
>>> with httpx.stream("GET", urls[0]) as response:
... image1 = Image.open(BytesIO(response.read()))
>>> with httpx.stream("GET", urls[1]) as response:
... image2 = Image.open(BytesIO(response.read()))
>>> images = [image1, image2]
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> inputs = processor(images, texts, padding=True, return_tensors="pt")
>>> loss = model(**inputs, return_loss=True).loss
>>> inputs = processor(images, texts[::-1], padding=True, return_tensors="pt")
>>> loss_swapped = model(**inputs, return_loss=True).loss
>>> print("Loss", round(loss.item(), 4))
Loss 0.0019
>>> print("Loss with swapped images", round(loss_swapped.item(), 4))
Loss with swapped images 2.126
```
## BridgeTowerForMaskedLM[[transformers.BridgeTowerForMaskedLM]]
#### transformers.BridgeTowerForMaskedLM[[transformers.BridgeTowerForMaskedLM]]
```python
transformers.BridgeTowerForMaskedLM(config: BridgeTowerConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1408)
**Paramètres :**
config ([BridgeTowerConfig](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Modèle BridgeTower avec une tête de modélisation de langage en haut, comme effectué lors de la préformation.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.BridgeTowerForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1426)
**Paramètres :**
input_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices de jetons de segment indiquant les première et deuxième parties des entrées. Les indices sont sélectionnés dans `[0, 1]` : - 0 correspond à un jeton de *phrase A*, - 1 correspond à un jeton de *phrase B*. [Que sont les identifiants de type de jeton ?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de [BridgeTowerImageProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Voir [BridgeTowerImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([BridgeTowerProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerProcessor) utilise [BridgeTowerImageProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) pour le traitement des images).
pixel_mask (`torch.LongTensor` de forme `(batch_size, height, width)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux valeurs de pixels de bourrage. Les valeurs du masque sont comprises dans `[0, 1]` : - 1 pour les pixels réels (c.-à-d. **non masqués**), - 0 pour les pixels de bourrage (c.-à-d. **masqués**). [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `input_ids`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indices `input_ids` en vecteurs associés, par rapport à la matrice de recherche d'intégration interne du modèle.
image_embeds (`torch.Tensor` de forme `(batch_size, num_patches, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `pixel_values`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir `pixel_values` en embeddings de patchs.
labels (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Étiquettes pour le calcul de la perte de modélisation de langage masquée. Les indices doivent être dans `[-100, 0, ..., config.vocab_size]` (voir la docstring de `input_ids`). Les jetons dont l'indice est défini sur `-100` sont ignorés (masqués) ; la perte n'est calculée que pour les jetons dont l'étiquette est dans `[0, ..., config.vocab_size]`.
**Retourne :** [MaskedLMOutput](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) ou `tuple(torch.Tensor)`
Un [MaskedLMOutput](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([BridgeTowerConfig](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerConfig)) et les entrées.
La méthode forward de [BridgeTowerForMaskedLM](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerForMaskedLM) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de modélisation de langage masquée (MLM).
- **logits** (`torch.Tensor` de forme `(batch_size, sequence_length, config.vocab_size)`) -- Scores de prédiction de la tête de modélisation du langage (scores pour chaque jeton du vocabulaire avant SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000360943.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> text = "a looking out of the window"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())
>>> print(results)
.a cat looking out of the window.
```
## BridgeTowerForImageAndTextRetrieval[[transformers.BridgeTowerForImageAndTextRetrieval]]
#### transformers.BridgeTowerForImageAndTextRetrieval[[transformers.BridgeTowerForImageAndTextRetrieval]]
```python
transformers.BridgeTowerForImageAndTextRetrieval(config: BridgeTowerConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1505)
**Paramètres :**
config ([BridgeTowerConfig](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Modèle BridgeTower transformer avec une tête de classifieur au sommet (une couche linéaire au-dessus de l'état caché final du jeton [CLS]) pour l'appariement image-texte.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.BridgeTowerForImageAndTextRetrieval.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1516)
**Paramètres :**
input_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices de jetons de segment indiquant les première et deuxième parties des entrées. Les indices sont sélectionnés dans `[0, 1]` : - 0 correspond à un jeton de *phrase A*, - 1 correspond à un jeton de *phrase B*. [Que sont les identifiants de type de jeton ?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de [BridgeTowerImageProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Voir [BridgeTowerImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([BridgeTowerProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerProcessor) utilise [BridgeTowerImageProcessor](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) pour le traitement des images).
pixel_mask (`torch.LongTensor` de forme `(batch_size, height, width)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux valeurs de pixels de bourrage. Les valeurs du masque sont comprises dans `[0, 1]` : - 1 pour les pixels réels (c.-à-d. **non masqués**), - 0 pour les pixels de bourrage (c.-à-d. **masqués**). [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `input_ids`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indices `input_ids` en vecteurs associés, par rapport à la matrice de recherche d'intégration interne du modèle.
image_embeds (`torch.Tensor` de forme `(batch_size, num_patches, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `pixel_values`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir `pixel_values` en embeddings de patchs.
labels (`torch.LongTensor` de forme `(batch_size, 1)`, *facultatif*) : Étiquettes pour le calcul de la perte d'adéquation image-texte. 0 signifie que les paires ne correspondent pas et 1 qu'elles correspondent. Les paires avec 0 seront ignorées lors du calcul.
**Retourne :** [SequenceClassifierOutput](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) ou `tuple(torch.Tensor)`
Un [SequenceClassifierOutput](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([BridgeTowerConfig](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerConfig)) et les entrées.
La méthode forward de [BridgeTowerForImageAndTextRetrieval](/docs/transformers/main/fr/model_doc/bridgetower#transformers.BridgeTowerForImageAndTextRetrieval) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de classification (ou de régression si config.num_labels==1).
- **logits** (`torch.Tensor` de forme `(batch_size, config.num_labels)`) -- Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> # forward pass
>>> scores = dict()
>>> for text in texts:
... # prepare inputs
... encoding = processor(image, text, return_tensors="pt")
... outputs = model(**encoding)
... scores[text] = outputs.logits[0, 1].item()
```