# BLIP-2
## Ikhtisar
Model BLIP-2 diusulkan dalam [BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models](https://huggingface.co/papers/2301.12597) oleh Junnan Li, Dongxu Li, Silvio Savarese, Steven Hoi. BLIP-2 memanfaatkan encoder gambar pre-trained yang dibekukan dan large language models (LLMs) dengan melatih encoder Transformer ringan berlapis 12 di antara keduanya, sehingga mencapai kinerja state-of-the-art pada berbagai tugas vision-language. Yang paling menonjol, BLIP-2 meningkatkan [Flamingo](https://huggingface.co/papers/2204.14198), sebuah model dengan 80 miliar parameter, sebesar 8,7% pada zero-shot VQAv2 dengan jumlah parameter yang dapat dilatih 54 kali lebih sedikit.
Abstrak dari makalah tersebut adalah sebagai berikut:
*Biaya pra-pelatihan visi-dan-bahasa menjadi semakin mahal karena pelatihan end-to-end pada model berskala besar. Kertas ini mengusulkan BLIP-2, sebuah strategi pra-pelatihan yang generik dan efisien yang mem-bootstrapping pra-pelatihan visi-bahasa dari encoder gambar pra-terlatih beku yang siap pakai dan model bahasa besar yang beku. BLIP-2 menjembatani kesenjangan modalitas dengan Querying Transformer yang ringan, yang dipra-latih dalam dua tahap. Tahap pertama mem-bootstrapping pembelajaran representasi visi-bahasa dari encoder gambar yang beku. Tahap kedua mem-bootstrapping pembelajaran generatif dari-visi-ke-bahasa dari model bahasa yang beku. BLIP-2 mencapai kinerja state-of-the-art pada berbagai tugas visi-bahasa, meskipun memiliki jumlah parameter yang dapat dilatih jauh lebih sedikit dibandingkan metode yang ada. Sebagai contoh, model kami melampaui Flamingo80B sebesar 8,7% pada zero-shot VQAv2 dengan 54x lebih sedikit parameter yang dapat dilatih. Kami juga menunjukkan kemampuan muncul model dalam generasi dari-gambar-ke-teks zero-shot yang dapat mengikuti instruksi bahasa alami.*
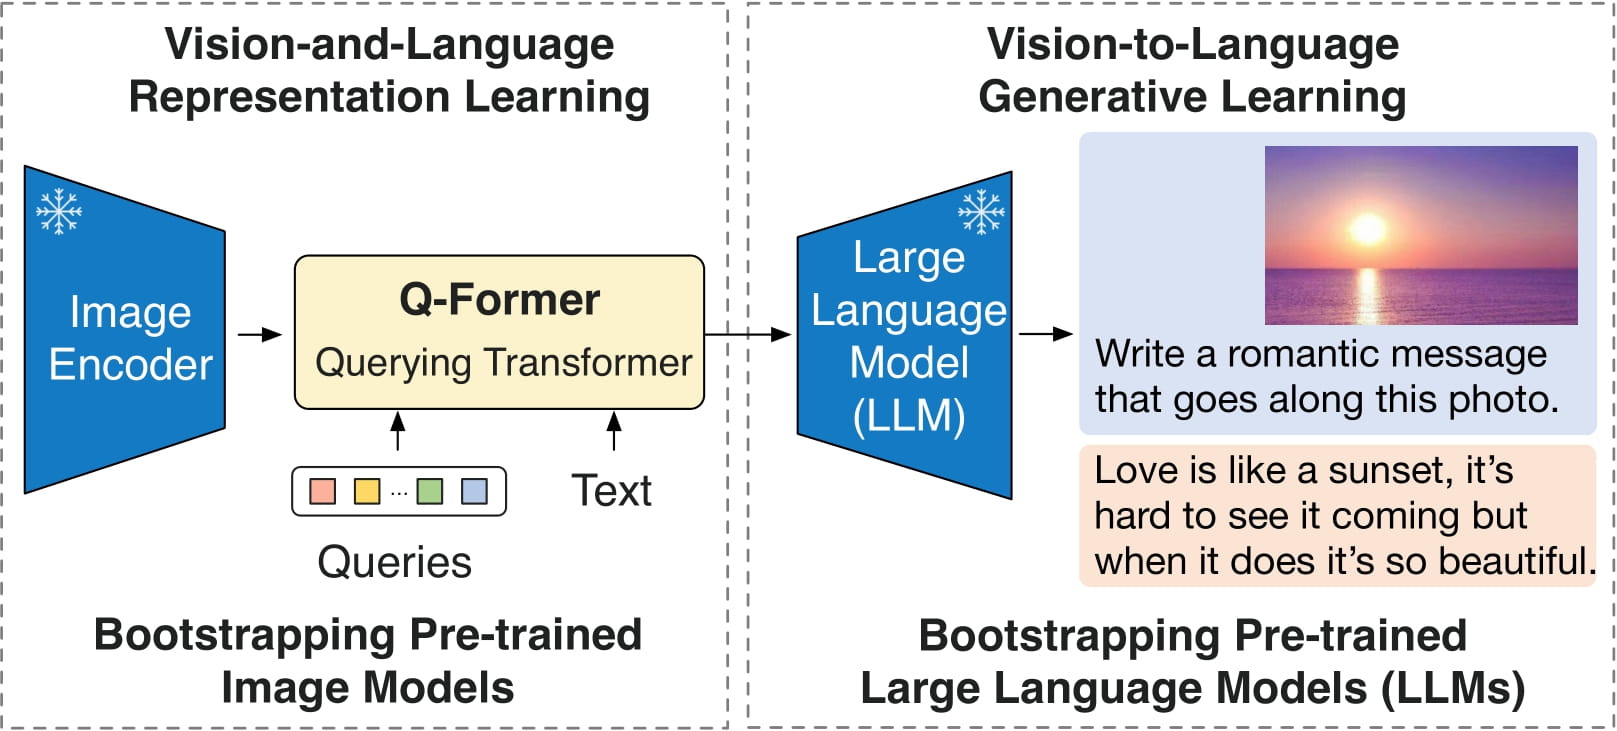 Arsitektur BLIP-2. Diambil dari paper aslinya.
Model ini disumbangkan oleh [nielsr](https://huggingface.co/nielsr). Kode aslinya dapat ditemukan [di sini](https://github.com/salesforce/LAVIS/tree/5ee63d688ba4cebff63acee04adaef2dee9af207).
## Tips penggunaan
- BLIP-2 dapat digunakan untuk menghasilkan teks bersyarat berdasarkan gambar dan prompt teks opsional. Saat inferensi, disarankan untuk menggunakan metode `generate`.
- Anda dapat menggunakan [Blip2Processor](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor) untuk menyiapkan gambar bagi model, dan mengurai ID token prediksi kembali menjadi teks.
> [!NOTE]
> Model BLIP setelah rilis v4.46 akan menampilkan peringatan tentang penambahan `processor.num_query_tokens = {{num_query_tokens}}` dan perluasan lapisan embeddings model untuk menambahkan token khusus ``. Sangat disarankan untuk menambahkan atribut tersebut ke processor jika Anda memiliki checkpoint model, atau membuka PR jika checkpoint tersebut bukan milik Anda. Penambahan atribut ini berarti BLIP akan menambahkan jumlah query token yang diperlukan per gambar dan memperluas teks dengan sebanyak `` placeholder sebanyak query token yang ada. Biasanya sekitar 500 token per gambar, jadi pastikan teks tidak dipotong (truncated) karena jika tidak, akan terjadi kegagalan saat menggabungkan embeddings.
Atribut dapat diperoleh dari konfigurasi model, seperti `model.config.num_query_tokens`, dan perluasan embedding model dapat dilakukan dengan mengikuti [tautan ini](https://gist.github.com/zucchini-nlp/e9f20b054fa322f84ac9311d9ab67042).
## Sumber daya
Daftar sumber resmi Hugging Face dan komunitas (ditandai dengan 🌎) untuk membantu Anda memulai dengan BLIP-2.
- Notebook demo untuk BLIP-2 untuk captioning gambar, visual question answering (VQA), dan percakapan bergaya chat dapat ditemukan [di sini](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/BLIP-2).
Jika Anda tertarik untuk mengirimkan sumber daya agar disertakan di sini, silakan buka Pull Request dan kami akan meninjaunya! Sumber daya tersebut sebaiknya mendemonstrasikan sesuatu yang baru, bukan menduplikasi sumber daya yang sudah ada.
## Blip2Config[[transformers.Blip2Config]]
#### transformers.Blip2Config[[transformers.Blip2Config]]
```python
transformers.Blip2Config(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, qformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_query_tokens: int = 32, image_text_hidden_size: int = 256, image_token_index: int | None = None, initializer_factor: float = 1.0, initializer_range: float = 0.02)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/configuration_blip_2.py#L107)
**Parameter:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opsional*) : Objek config atau dictionary dari vision backbone.
qformer_config (`dict`, *opsional*) : Kamus opsi konfigurasi yang digunakan untuk menginisialisasi [Blip2QFormerConfig](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2QFormerConfig).
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opsional*) : Objek config atau dictionary dari text backbone.
num_query_tokens (`int`, *opsional*, defaultnya 32) : Jumlah token query yang diteruskan melalui Transformer.
image_text_hidden_size (`int`, *opsional*, default 256) : Dimensi dari hidden state pada lapisan fusi gambar-teks.
image_token_index (`int`, *opsional*) : Indeks token gambar yang digunakan sebagai placeholder untuk gambar input.
initializer_factor (`float`, *opsional*, default `1.0`) : Faktor untuk menginisialisasi semua matriks bobot (sebaiknya tetap 1, digunakan secara internal untuk pengujian inisialisasi).
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi model Blip 2. Kelas ini digunakan untuk membuat instans model Blip 2 berdasarkan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi [Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import (
... Blip2VisionConfig,
... Blip2QFormerConfig,
... OPTConfig,
... Blip2Config,
... Blip2ForConditionalGeneration,
... )
>>> # Initializing a Blip2Config with Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2Config()
>>> # Initializing a Blip2ForConditionalGeneration (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2ForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a Blip2Config from a Blip2VisionConfig, Blip2QFormerConfig and any PreTrainedConfig
>>> # Initializing BLIP-2 vision, BLIP-2 Q-Former and language model configurations
>>> vision_config = Blip2VisionConfig()
>>> qformer_config = Blip2QFormerConfig()
>>> text_config = OPTConfig()
>>> config = Blip2Config(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
```
## Blip2VisionConfig[[transformers.Blip2VisionConfig]]
#### transformers.Blip2VisionConfig[[transformers.Blip2VisionConfig]]
```python
transformers.Blip2VisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 1408, intermediate_size: int = 6144, num_hidden_layers: int = 39, num_attention_heads: int = 16, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 14, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/configuration_blip_2.py#L29)
**Parameter:**
hidden_size (`int`, *opsional*, defaultnya `1408`) : Dimensi dari representasi tersembunyi.
intermediate_size (`int`, *opsional*, defaultnya `6144`) : Dimensi dari representasi MLP.
num_hidden_layers (`int`, *opsional*, defaultnya `39`) : Jumlah lapisan tersembunyi dalam decoder Transformer.
num_attention_heads (`int`, *opsional*, defaultnya `16`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
image_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `224`) : Ukuran (resolusi) dari setiap gambar.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `14`) : Ukuran (resolusi) dari setiap patch.
hidden_act (`str`, *opsional*, defaultnya `gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
layer_norm_eps (`float`, *opsional*, defaultnya `1e-06`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
attention_dropout (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Rasio dropout untuk probabilitas perhatian.
initializer_range (`float`, *opsional*, defaultnya `1e-10`) : Standar deviasi dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
qkv_bias (`bool`, *opsional*, defaultnya `True`) : Apakah akan menambahkan bias ke queries, keys, dan values.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi model Blip 2. Kelas ini digunakan untuk membuat instans model Blip 2 berdasarkan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi [Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import Blip2VisionConfig, Blip2VisionModel
>>> # Initializing a Blip2VisionConfig with Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2VisionConfig()
>>> # Initializing a Blip2VisionModel (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2VisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Blip2QFormerConfig[[transformers.Blip2QFormerConfig]]
#### transformers.Blip2QFormerConfig[[transformers.Blip2QFormerConfig]]
```python
transformers.Blip2QFormerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, cross_attention_frequency: int = 2, encoder_hidden_size: int = 1408, use_qformer_text_input: bool = False)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/configuration_blip_2.py#L64)
**Parameter:**
vocab_size (`int`, *opsional*, defaultnya `30522`) : Ukuran kosakata model. Menentukan jumlah token berbeda yang dapat direpresentasikan oleh `input_ids`.
hidden_size (`int`, *opsional*, defaultnya `768`) : Dimensi dari representasi tersembunyi.
num_hidden_layers (`int`, *opsional*, defaultnya `12`) : Jumlah lapisan tersembunyi dalam decoder Transformer.
num_attention_heads (`int`, *opsional*, defaultnya `12`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
intermediate_size (`int`, *opsional*, defaultnya `3072`) : Dimensi dari representasi MLP.
hidden_act (`str`, *opsional*, defaultnya `gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
hidden_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.1`) : Probabilitas dropout untuk semua lapisan fully connected di embeddings, encoder, dan pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.1`) : Rasio dropout untuk probabilitas perhatian.
max_position_embeddings (`int`, *opsional*, defaultnya `512`) : Panjang urutan maksimum yang mungkin digunakan oleh model ini.
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
layer_norm_eps (`float`, *opsional*, defaultnya `1e-12`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
pad_token_id (`int`, *opsional*, defaultnya `0`) : ID token yang digunakan untuk padding dalam kosakata.
cross_attention_frequency (`int`, *opsional*, defaultnya 2) : Frekuensi penambahan cross-attention ke lapisan Transformer.
encoder_hidden_size (`int`, *opsional*, defaultnya `1408`) : Dimensi dari representasi tersembunyi.
use_qformer_text_input (`bool`, *opsional*, defaultnya `False`) : Apakah akan menggunakan embedding gaya BERT.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi model Blip 2. Kelas ini digunakan untuk membuat instans model Blip 2 berdasarkan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi [Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import Blip2QFormerConfig, Blip2QFormerModel
>>> # Initializing a BLIP-2 Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2QFormerConfig()
>>> # Initializing a model (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2QFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Blip2Processor[[transformers.Blip2Processor]]
#### transformers.Blip2Processor[[transformers.Blip2Processor]]
```python
transformers.Blip2Processor(image_processor, tokenizer, num_query_tokens = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/processing_blip_2.py#L30)
**Parameter:**
image_processor (`BlipImageProcessor`) : Prosesor gambar adalah input yang wajib.
tokenizer (`GPT2Tokenizer`) : Tokenizer adalah input yang wajib.
num_query_tokens (`int`, *opsional*) : Jumlah token yang digunakan oleh Qformer sebagai query, harus sama dengan yang ada di konfigurasi model.
Membangun Blip2Processor yang membungkus image processor dan tokenizer menjadi satu processor.
[Blip2Processor](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor) menyediakan semua fungsionalitas dari [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor) dan [GPT2Tokenizer](/docs/transformers/v5.23.0/id/model_doc/gpt2#transformers.GPT2Tokenizer). Lihat [~BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor) dan [~GPT2Tokenizer](/docs/transformers/v5.23.0/id/model_doc/gpt2#transformers.GPT2Tokenizer) untuk informasi lebih lanjut.
#### __call__[[transformers.Blip2Processor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | None = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/processing_blip_2.py#L50)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opsional*) : Gambar untuk dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
text (`Union[str, list[str]]`, *opsional*) : Urutan atau batch dari urutan yang akan dienkod. Setiap urutan dapat berupa string atau daftar string (string pretokenized). Jika Anda memasukkan input pretokenized, atur `is_split_into_words=True` untuk menghindari ambiguitas dengan input batched.
return_mm_token_type_ids (`bool`, *kwargs*) : Apakah akan mengembalikan id tipe token multimodal yang menunjukkan posisi token placeholder multimodal.
return_text_replacement_offsets (`bool`, *kwargs*) : Apakah akan mengembalikan offset karakter untuk setiap placeholder multimodal dan pengantinya.
return_tensors (`str` atau [TensorType](/docs/transformers/v5.23.0/id/internal/file_utils#transformers.TensorType), *opsional*) : Jika diatur, akan mengembalikan tensor dari framework tertentu. Nilai yang dapat diterima adalah: - `'pt'`: Mengembalikan objek `torch.Tensor` PyTorch. - `'np'`: Mengembalikan objek `np.ndarray` NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/id/main_classes/processors#transformers.ProcessingKwargs), *opsional*) : Opsi pemrosesan tambahan untuk setiap modalitas (teks, gambar, video, audio). Parameter spesifik model tercantum di atas; lihat kelas TypedDict untuk daftar lengkap argumen yang didukung.
**Mengembalikan:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *opsional*) -- Kamus berisi daftar/array/tensor yang dikembalikan oleh metode `__call__`/`encode_plus`/`batch_encode_plus` ('input_ids', 'attention_mask', dll.).
- **encoding** (`tokenizers.Encoding` atau `Sequence[tokenizers.Encoding]`, *opsional*) -- Jika tokenizer adalah fast tokenizer yang mengoutputkan informasi tambahan seperti pemetaan dari ruang kata/karakter ke ruang token, instance `tokenizers.Encoding` atau daftar instance (untuk batch) menyimpan informasi ini.
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
- **prepend_batch_axis** (`bool`, *opsional*, default `False`) -- Apakah akan menambahkan sumbu batch saat mengonversi ke tensor (lihat `tensor_type` di atas). Perhatikan bahwa parameter ini berpengaruh jika parameter `tensor_type` disetel, *tidak berpengaruh jika tidak*.
- **n_sequences** (`int`, *opsional*) -- Jumlah urutan input yang direpresentasikan oleh setiap encoding (`None` untuk tidak diketahui, `1` untuk satu urutan, dan `2` untuk sepasang urutan).
## Blip2VisionModel[[transformers.Blip2VisionModel]]
#### transformers.Blip2VisionModel[[transformers.Blip2VisionModel]]
```python
transformers.Blip2VisionModel(config: Blip2VisionConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L481)
**Parameter:**
config ([Blip2VisionConfig](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2VisionConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model Blip 2 polos yang menghasilkan hidden-states mentah tanpa head spesifik di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.Blip2VisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L501)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor). Lihat [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([Blip2Processor](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor) menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor) untuk memproses gambar).
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) dan input.
Metode forward dari [Blip2VisionModel](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2VisionModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
## Blip2QFormerModel[[transformers.Blip2QFormerModel]]
#### transformers.Blip2QFormerModel[[transformers.Blip2QFormerModel]]
```python
transformers.Blip2QFormerModel(config: Blip2QFormerConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L848)
**Parameter:**
config ([Blip2QFormerConfig](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2QFormerConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
BLIP-2 Querying Transformer (Q-Former).
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.Blip2QFormerModel.forward]]
```python
forward(query_embeds: Tensor, query_length: int | None = None, attention_mask: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L885)
**Parameter:**
query_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) : Hidden states yang akan digunakan dalam komputasi attention. Jika cross-attention, akan digunakan untuk query (yaitu, key dan value akan menggunakan encoder_hidden_states).
query_length (`int`, *opsional*) : Panjang query, biasanya berdasarkan jumlah token query. Jika tidak ada nilai yang diberikan, query_length akan disimpulkan oleh query_embeds.
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
encoder_hidden_states (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Urutan hidden-states pada keluaran lapisan terakhir encoder. Digunakan dalam cross-attention jika model dikonfigurasi sebagai decoder.
encoder_attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding dari input encoder. Mask ini digunakan dalam cross-attention jika model dikonfigurasi sebagai decoder. Nilai mask yang dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**.
**Mengembalikan:** [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) atau `tuple(torch.Tensor)`
A [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) dan input.
Metode forward dari [Blip2QFormerModel](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2QFormerModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
- **cross_attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dan `config.add_cross_attention=True` diteruskan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap lapisan) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian dari lapisan cross-attention decoder, setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di kepala cross-attention.
- **past_key_values** (`Cache`, *opsional*, dikembalikan saat `use_cache=True` dilewatkan atau saat `config.use_cache=True`) -- Ini adalah instance [Cache](/docs/transformers/v5.23.0/id/internal/generation_utils#transformers.Cache). Untuk detail lebih lanjut, lihat [panduan kv cache](https://huggingface.co/docs/transformers/en/kv_cache) kami.
Berisi hidden-states yang telah dihitung sebelumnya (key dan values di blok self-attention, dan secara opsional jika `config.is_encoder_decoder=True` di blok cross-attention) yang dapat digunakan (lihat input `past_key_values`) untuk mempercepat decoding berurutan.
## Blip2Model[[transformers.Blip2Model]]
#### transformers.Blip2Model[[transformers.Blip2Model]]
```python
transformers.Blip2Model(config: Blip2Config)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L957)
**Parameter:**
config ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model BLIP-2 untuk menghasilkan teks dan fitur gambar. Model ini terdiri dari encoder visual, Querying Transformer (Q-Former), dan model bahasa.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.Blip2Model.forward]]
```python
forward(pixel_values: Tensor, input_ids: Tensor, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1152)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor). Lihat [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([Blip2Processor](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor) menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor) untuk memproses gambar).
input_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/v5.23.0/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` dengan bentuk `(batch_size, target_sequence_length)`, *opsional*) : Indeks token dari urutan input decoder dalam kosakata. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/v5.23.0/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu ID input decoder?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` dengan bentuk `(batch_size, target_sequence_length)`, *opsional*) : Perilaku bawaan: menghasilkan tensor yang mengabaikan token pad di `decoder_input_ids`. Mask kausal juga akan digunakan secara bawaan. Hanya relevan jika model bahasa encoder-decoder (seperti T5) digunakan.
labels (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Label untuk menghitung kerugian pemodelan bahasa yang disamarkan. Indeks harus berada di `[0, ..., config.vocab_size]` atau -100 (lihat docstring `input_ids`). Token dengan indeks yang disetel ke `-100` diabaikan (disamarkan), kerugian hanya dihitung untuk token dengan label di `[0, ..., config.vocab_size]`.
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** `Blip2ForConditionalGenerationModelOutput` atau `tuple(torch.Tensor)`
Sebuah `Blip2ForConditionalGenerationModelOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) dan input.
Metode forward dari [Blip2Model](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Model) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor`, *opsional*, dikembalikan saat `labels` disediakan, `torch.Tensor` dengan bentuk `(1,)`) -- Loss pemodelan bahasa dari model bahasa.
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, config.vocab_size)`) -- Skor prediksi dari kepala pemodelan bahasa (language modeling head) dari model bahasa.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *opsional*) -- Output dari vision encoder.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *opsional*) -- Output dari Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` atau `Seq2SeqLMOutput`) -- Output dari model bahasa.
Contoh:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import Blip2Processor, Blip2Model
>>> import torch
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b", dtype=torch.float16)
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> prompt = "Question: how many cats are there? Answer:"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device, torch.float16)
>>> outputs = model(**inputs)
```
#### get_text_features[[transformers.Blip2Model.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, decoder_input_ids: typing.Optional[torch.Tensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L994)
**Parameter:**
input_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/v5.23.0/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` dengan bentuk `(batch_size, target_sequence_length)`, *opsional*) : Indeks token dari urutan input decoder dalam kosakata. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/v5.23.0/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu decoder input IDs?](../glossary#decoder-input-ids) T5 menggunakan `pad_token_id` sebagai token awal untuk generasi `decoder_input_ids`. Jika `past_key_values` digunakan, secara opsional hanya `decoder_input_ids` terakhir yang perlu diinput (lihat `past_key_values`). Untuk mengetahui lebih lanjut tentang cara menyiapkan `decoder_input_ids` untuk pretraining, lihat [T5 Training](./t5#training).
decoder_attention_mask (`torch.BoolTensor` dengan bentuk `(batch_size, target_sequence_length)`, *opsional*) : Perilaku bawaan: menghasilkan tensor yang mengabaikan token pad di `decoder_input_ids`. Mask kausal juga akan digunakan secara bawaan.
labels (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Label untuk menghitung kerugian pemodelan bahasa yang disamarkan. Indeks harus berada di `[0, ..., config.vocab_size]` atau -100 (lihat docstring `input_ids`). Token dengan indeks yang disetel ke `-100` diabaikan (disamarkan), kerugian hanya dihitung untuk token dengan label di `[0, ..., config.vocab_size]`.
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) dan input.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import torch
>>> from transformers import AutoTokenizer, Blip2Model
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> tokenizer = AutoTokenizer.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> inputs = tokenizer(["a photo of a cat"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.Blip2Model.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1056)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor). Lihat [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([Blip2Processor](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor) menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor) untuk memproses gambar).
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) dan input.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2Model
>>> from transformers.image_utils import load_image
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_outputs = model.get_image_features(**inputs)
```
#### get_qformer_features[[transformers.Blip2Model.get_qformer_features]]
```python
get_qformer_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1087)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor). Lihat [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([Blip2Processor](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor) menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor) untuk memproses gambar).
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** qformer_outputs (`torch.Tensor`)
Hidden states dari lapisan terakhir model Q-Former.
Contoh:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2Model
>>> from transformers.image_utils import load_image
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... qformer_outputs = model.get_qformer_features(**inputs)
```
## Blip2ForConditionalGeneration[[transformers.Blip2ForConditionalGeneration]]
#### transformers.Blip2ForConditionalGeneration[[transformers.Blip2ForConditionalGeneration]]
```python
transformers.Blip2ForConditionalGeneration(config: Blip2Config)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1460)
**Parameter:**
config ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model BLIP-2 untuk menghasilkan teks berdasarkan gambar dan prompt teks opsional. Model ini terdiri dari encoder visual, Querying Transformer (Q-Former), dan model bahasa.
Secara opsional, Anda dapat meneruskan `input_ids` ke model, yang berfungsi sebagai prompt teks, agar model bahasa melanjutkan prompt tersebut. Jika tidak, model bahasa akan mulai menghasilkan teks dari token [BOS] (beginning-of-sequence).
Perhatikan bahwa checkpoint Flan-T5 tidak dapat di-cast ke float16. Mereka dilatih sebelumnya menggunakan bfloat16.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.Blip2ForConditionalGeneration.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1587)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor). Lihat [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([Blip2Processor](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor) menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor) untuk memproses gambar).
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata model bahasa. Token input dapat diberikan secara opsional untuk berfungsi sebagai prompt teks, yang dapat dilanjutkan oleh model bahasa. Indeks dapat diperoleh menggunakan [Blip2Processor](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor). Lihat [Blip2Processor.__call__()](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor.__call__) untuk detail. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` dengan bentuk `(batch_size, target_sequence_length)`, *opsional*) : Indeks token dari urutan input decoder dalam kosakata. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/v5.23.0/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu ID input decoder?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` dengan bentuk `(batch_size, target_sequence_length)`, *opsional*) : Perilaku bawaan: menghasilkan tensor yang mengabaikan token pad di `decoder_input_ids`. Mask kausal juga akan digunakan secara bawaan. Hanya relevan jika model bahasa encoder-decoder (seperti T5) digunakan.
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model.
labels (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Label untuk menghitung kerugian pemodelan bahasa yang disamarkan. Indeks harus berada di `[0, ..., config.vocab_size]` atau -100 (lihat docstring `input_ids`). Token dengan indeks yang disetel ke `-100` diabaikan (disamarkan), kerugian hanya dihitung untuk token dengan label di `[0, ..., config.vocab_size]`.
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *opsional*) : Dict di mana kuncinya adalah modalitas yang didukung dan nilainya adalah output terenkod untuk modalitas tersebut. Setiap output terenkod adalah tuple yang terdiri dari (`pooler_output`, *opsional*: `last_hidden_states`, *opsional*: `hidden_states`, *opsional*: `attentions`) `pooler_output` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) adalah rangkaian fitur multimodal dari encoder yang digabungkan ke dalam embedding teks.
**Mengembalikan:** `Blip2ForConditionalGenerationModelOutput` atau `tuple(torch.Tensor)`
Sebuah `Blip2ForConditionalGenerationModelOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) dan input.
Metode forward dari [Blip2ForConditionalGeneration](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2ForConditionalGeneration) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor`, *opsional*, dikembalikan saat `labels` disediakan, `torch.Tensor` dengan bentuk `(1,)`) -- Loss pemodelan bahasa dari model bahasa.
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, config.vocab_size)`) -- Skor prediksi dari kepala pemodelan bahasa (language modeling head) dari model bahasa.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *opsional*) -- Output dari vision encoder.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *opsional*) -- Output dari Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` atau `Seq2SeqLMOutput`) -- Output dari model bahasa.
Contoh:
Siapkan prosesor, model, dan input gambar
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import Blip2Processor, Blip2ForConditionalGeneration
>>> import torch
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2ForConditionalGeneration.from_pretrained(
... "Salesforce/blip2-opt-2.7b", load_in_8bit=True, device_map={"": 0}, dtype=torch.float16
... ) # doctest: +IGNORE_RESULT
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
```
Penamaan gambar (tanpa memberikan prompt teks):
```python
>>> inputs = processor(images=image, return_tensors="pt").to(device, torch.float16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two cats laying on a couch
```
Jawaban pertanyaan visual (prompt = pertanyaan):
```python
>>> prompt = "Question: how many cats are there? Answer:"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device="cuda", dtype=torch.float16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two
```
Perhatikan bahwa inferensi int8 juga didukung melalui [bitsandbytes](https://github.com/TimDettmers/bitsandbytes). Hal ini sangat mengurangi jumlah memori yang digunakan oleh model sambil mempertahankan kinerja yang sama.
```python
>>> model = Blip2ForConditionalGeneration.from_pretrained(
... "Salesforce/blip2-opt-2.7b", load_in_8bit=True, device_map={"": 0}, dtype=torch.bfloat16
... ) # doctest: +IGNORE_RESULT
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device="cuda", dtype=torch.bfloat16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two
```
#### generate[[transformers.Blip2ForConditionalGeneration.generate]]
```python
generate(pixel_values: Tensor, input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **generate_kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1738)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk (batch_size, num_channels, height, width)) : Gambar input yang akan diproses.
input_ids (`torch.LongTensor` dengan bentuk (batch_size, sequence_length), *opsional*) : Urutan yang digunakan sebagai prompt untuk generasi.
attention_mask (`torch.LongTensor` dengan bentuk (batch_size, sequence_length), *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) : Representasi tertanam dari input. Harus berupa float, bukan token int.
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi encoding posisi dari embedding gambar.
**Mengembalikan:** `captions (list)`
Daftar string dengan panjang batch_size * num_captions.
Menimpa fungsi `generate` agar model dapat digunakan sebagai generator kondisional.
#### get_image_features[[transformers.Blip2ForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1519)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input.
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** `BaseModelOutputWithVisionQformerOutputs` atau `tuple(torch.Tensor)`
A `BaseModelOutputWithVisionQformerOutputs` atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) dan input.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *opsional*) -- Output dari vision encoder.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *opsional*) -- Output dari Q-Former (Querying Transformer).
Contoh:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, Blip2ForConditionalGeneration
>>> model = Blip2ForConditionalGeneration.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```
## Blip2ForImageTextRetrieval[[transformers.Blip2ForImageTextRetrieval]]
#### transformers.Blip2ForImageTextRetrieval[[transformers.Blip2ForImageTextRetrieval]]
```python
transformers.Blip2ForImageTextRetrieval(config: Blip2Config)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1832)
**Parameter:**
config ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model BLIP-2 dengan proyektor visual dan teks, serta kepala klasifikasi di atasnya. Model ini digunakan dalam konteks pengambilan gambar-teks. Diberikan sebuah gambar dan teks, model mengembalikan probabilitas bahwa teks tersebut relevan dengan gambar.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.Blip2ForImageTextRetrieval.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, attention_mask: typing.Optional[torch.LongTensor] = None, use_image_text_matching_head: bool | None = False, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1866)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor). Lihat [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([Blip2Processor](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor) menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor) untuk memproses gambar).
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata model bahasa. Token input dapat diberikan secara opsional untuk berfungsi sebagai prompt teks, yang dapat dilanjutkan oleh model bahasa. Indeks dapat diperoleh menggunakan [Blip2Processor](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor). Lihat [Blip2Processor.__call__()](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor.__call__) untuk detail. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
use_image_text_matching_head (`bool`, *opsional*) : Apakah akan mengembalikan skor Image-Text Matching atau Contrastive.
output_attentions (`bool`, *opsional*) : Apakah akan mengembalikan tensor perhatian dari semua lapisan perhatian. Lihat `attentions` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
output_hidden_states (`bool`, *opsional*) : Apakah akan mengembalikan hidden states dari semua lapisan. Lihat `hidden_states` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
return_dict (`bool`, *opsional*) : Apakah akan mengembalikan [ModelOutput](/docs/transformers/v5.23.0/id/main_classes/output#transformers.utils.ModelOutput) alih-alih tuple biasa.
**Mengembalikan:** `Blip2ImageTextMatchingModelOutput` atau `tuple(torch.Tensor)`
`Blip2ImageTextMatchingModelOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) dan input.
Metode forward dari [Blip2ForImageTextRetrieval](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2ForImageTextRetrieval) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan ketika `return_loss` bernilai `True`) -- Contrastive loss untuk kemiripan gambar-teks.
- **logits_per_image** (`torch.Tensor` dengan bentuk `(image_batch_size, text_batch_size)`) -- Skor hasil perkalian titik (dot product) yang telah diskalakan antara `image_embeds` dan `text_embeds`. Ini mewakili skor kemiripan antara gambar dan teks.
- **logits_per_text** (`torch.Tensor` dengan bentuk `(text_batch_size, image_batch_size)`) -- Skor hasil perkalian titik berskala antara `text_embeds` dan `image_embeds`. Ini mewakili skor kemiripan teks-gambar.
- **text_embeds** (`torch.Tensor` dengan bentuk `(batch_size, output_dim`) -- Embedding teks yang diperoleh dengan menerapkan lapisan proyeksi ke output yang telah dipooling.
- **image_embeds** (`torch.Tensor` dengan bentuk `(batch_size, output_dim`) -- Embedding gambar yang diperoleh dengan menerapkan lapisan proyeksi ke output yang telah di-pool.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opsional*) -- Output dari [Blip2QFormerModel](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2QFormerModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opsional*) -- Output dari [Blip2VisionModel](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2VisionModel).
Contoh:
```python
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, Blip2ForImageTextRetrieval
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model = Blip2ForImageTextRetrieval.from_pretrained("Salesforce/blip2-itm-vit-g", dtype=torch.float16)
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "two cats laying on a pink blanket"
>>> inputs = processor(images=image, text=text, return_tensors="pt").to(device, torch.float16)
>>> itm_out = model(**inputs, use_image_text_matching_head=True)
>>> logits_per_image = torch.nn.functional.softmax(itm_out.logits_per_image, dim=1)
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(f"{probs[0][0]:.1%} that image 0 is not '{text}'")
26.9% that image 0 is not 'two cats laying on a pink blanket'
>>> print(f"{probs[0][1]:.1%} that image 0 is '{text}'")
73.0% that image 0 is 'two cats laying on a pink blanket'
>>> texts = ["a photo of a cat", "a photo of a dog"]
>>> inputs = processor(images=image, text=texts, return_tensors="pt").to(device, torch.float16)
>>> itc_out = model(**inputs, use_image_text_matching_head=False)
>>> logits_per_image = itc_out.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(f"{probs[0][0]:.1%} that image 0 is '{texts[0]}'")
55.3% that image 0 is 'a photo of a cat'
>>> print(f"{probs[0][1]:.1%} that image 0 is '{texts[1]}'")
44.7% that image 0 is 'a photo of a dog'
```
## Blip2TextModelWithProjection[[transformers.Blip2TextModelWithProjection]]
#### transformers.Blip2TextModelWithProjection[[transformers.Blip2TextModelWithProjection]]
```python
transformers.Blip2TextModelWithProjection(config: Blip2Config)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1274)
**Parameter:**
config ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model Blip 2 dengan lapisan proyeksi di atasnya (lapisan linear di atas output yang dipooling).
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.Blip2TextModelWithProjection.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1298)
**Parameter:**
input_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/v5.23.0/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
position_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks posisi token dari setiap urutan input dalam embedding posisi. Dipilih dalam rentang `[0, config.n_positions - 1]`. [Apa itu position ID?](../glossary#position-ids)
**Mengembalikan:** `Blip2TextModelOutput` atau `tuple(torch.Tensor)`
`Blip2TextModelOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) dan input.
Metode forward dari [Blip2TextModelWithProjection](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2TextModelWithProjection) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **text_embeds** (`torch.Tensor` dengan bentuk `(batch_size, output_dim)` *opsional* dikembalikan saat model diinisialisasi dengan `with_projection=True`) -- Embedding teks yang diperoleh dengan menerapkan lapisan proyeksi ke pooler_output.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) -- Urutan hidden-states pada keluaran dari lapisan terakhir model.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *opsional*, dikembalikan ketika `output_hidden_states=True` dilewatkan atau ketika `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple[torch.Tensor, ...]`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2TextModelWithProjection
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model = Blip2TextModelWithProjection.from_pretrained(
... "Salesforce/blip2-itm-vit-g", dtype=torch.float16
... )
>>> model.to(device)
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> inputs = processor(text=["a photo of a cat", "a photo of a dog"], return_tensors="pt").to(device)
>>> outputs = model(**inputs)
>>> text_embeds = outputs.text_embeds
>>> print(text_embeds.shape)
torch.Size([2, 7, 256])
```
## Blip2VisionModelWithProjection[[transformers.Blip2VisionModelWithProjection]]
#### transformers.Blip2VisionModelWithProjection[[transformers.Blip2VisionModelWithProjection]]
```python
transformers.Blip2VisionModelWithProjection(config: Blip2Config)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1359)
**Parameter:**
config ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model Blip 2 dengan lapisan proyeksi di atasnya (lapisan linear di atas output yang dipooling).
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.Blip2VisionModelWithProjection.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1382)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor). Lihat [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([Blip2Processor](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Processor) menggunakan [BlipImageProcessor](/docs/transformers/v5.23.0/id/model_doc/blip#transformers.BlipImageProcessor) untuk memproses gambar).
**Mengembalikan:** `Blip2VisionModelOutput` atau `tuple(torch.Tensor)`
`Blip2VisionModelOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([Blip2Config](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2Config)) dan input.
Metode forward dari [Blip2VisionModelWithProjection](/docs/transformers/v5.23.0/id/model_doc/blip-2#transformers.Blip2VisionModelWithProjection) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **image_embeds** (`torch.Tensor` dengan bentuk `(batch_size, output_dim)` *opsional* yang dikembalikan saat model diinisialisasi dengan `with_projection=True`) -- Embedding gambar yang diperoleh dengan menerapkan lapisan proyeksi ke pooler_output.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) -- Urutan hidden-states pada keluaran dari lapisan terakhir model.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *opsional*, dikembalikan ketika `output_hidden_states=True` dilewatkan atau ketika `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple[torch.Tensor, ...]`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2VisionModelWithProjection
>>> from transformers.image_utils import load_image
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> model = Blip2VisionModelWithProjection.from_pretrained(
... "Salesforce/blip2-itm-vit-g", dtype=torch.float16
... )
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt").to(device, torch.float16)
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> image_embeds = outputs.image_embeds
>>> print(image_embeds.shape)
torch.Size([1, 32, 256])
```